LCEL 체인 플레이어
components.py 의 부품 세 개를 따로 돌린 결과부터 lcel_basic.py 의 invoke, stream, batch 와 lcel_debug.py 의 tap 관찰 지점까지 13단계로 따라갑니다. 단계마다 실제 코드 줄, 부품 사이를 지나가는 값의 타입(dict, PromptValue, AIMessage, str), 터미널 출력이 함께 바뀝니다.
강의를 따라가며 만든 자료와, 정리하면서 빈 주제를 채워 새로 만든 흐름도·단계별 플레이어·정리 페이지 37개, 그리고 그래프 구조 그림 4장입니다. 카드의 여기서 열기를 누르면 이 화면 위에 바로 뜹니다.
components.py 의 부품 세 개를 따로 돌린 결과부터 lcel_basic.py 의 invoke, stream, batch 와 lcel_debug.py 의 tap 관찰 지점까지 13단계로 따라갑니다. 단계마다 실제 코드 줄, 부품 사이를 지나가는 값의 타입(dict, PromptValue, AIMessage, str), 터미널 출력이 함께 바뀝니다.
Pydantic 스키마가 get_format_instructions() 로 형식 지침이 되어 프롬프트에 끼고, 모델이 쓴 JSON 글자가 JsonOutputParser 를 거쳐 dict 가 되는 과정을 structured_output.py 로 보여 준 뒤, RunnableParallel 이 같은 입력을 분류 체인과 초안 체인에 동시에 넣어 routing / draft 로 합치는 과정을 14단계로 따라갑니다. my_inquiry_chain.py 응용판의 차이도 짚습니다.
limits.py 의 상태 망각에서 출발해 multiturn_manual.py 의 chat_history 가 턴마다 자라며 입력 토큰이 늘어나는 모습, multiturn_history.py 의 RunnableWithMessageHistory 가 session_id 별로 기록을 나누는 모습을 14단계로 따라가고, 이 방식이 5일차의 thread_id 와 체크포인터로 이어지는 지점을 표로 정리했습니다.
@tool 이 함수 이름, docstring, 타입 힌트로 도구 설명서를 만들고 bind_tools 가 그것을 요청에 싣는 데서 시작해, 박도윤 이메일 알려주고, 부산 날씨도 알려줘. 라는 질문 하나로 주문서(tool_calls) → 우리 코드의 실행 → ToolMessage → 다시 모델 호출 → 종료까지 messages 가 1개에서 5개로 자라는 과정을 14단계로 보여 줍니다. max_turns 와 실패를 문자열로 돌려주는 도구 설계도 짚습니다.
연차 규정 323자가 (100, 0), (100, 50), (300, 50) 설정에서 어디서 잘리는지를 원고의 실제 청크 수와 글자 수로 그리고, 마크다운 헤더 분할과 청크에 붙는 메타데이터, 글이 Titan v2 벡터가 되어 cosine 함수로 비교되는 과정을 11단계 플레이어로 보여 줍니다. 유사도 수치는 싣지 않고 계산식과 확인하려는 관계만 다룹니다.
색인 단계(로드, 메타데이터, 청킹, 임베딩, Chroma 저장)와 질의 단계를 구조도와 14단계 플레이어로 보여 줍니다. 질문 하나가 문자열에서 dict, 메시지, 답 문자열로 모양을 바꾸는 과정을 실제 코드 줄과 나란히 놓고, verify.py 와 verify_sources.py 로 근거를 확인하는 방법까지 다룹니다.
failures.py 로 벡터 검색의 약점을 재현하고, Kiwi 토크나이저와 BM25, EnsembleRetriever 의 가중 RRF, CrossEncoder 재랭킹, eval.py 의 채점 규칙을 14단계 플레이어로 보여 줍니다. 토크나이저와 BM25 점수는 로컬에서 재현한 사실만 싣고, RRF 는 가상의 순위로 가중치를 바꿔 가며 계산해 볼 수 있습니다.
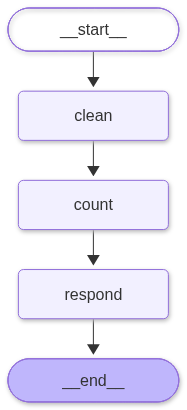
그래프 구조, State가 바뀌는 과정, 코드와 그림의 대응을 한 장에 정리한 자료입니다. 노드가 respond 하나뿐이던 초기 버전을 기준으로 만든 것이라 지금 파일(노드 3개)보다 단순하지만, 설계도 → compile → invoke 의 뼈대는 같습니다.
reducer가 없을 때(덮어쓰기)와 add_messages 를 붙였을 때(이어 쓰기)를 나란히 놓고, reducer.py 의 1차·2차 실행에서 메시지가 2개, 4개로 쌓이는 과정과 add_messages 를 뺐을 때 질문이 사라지는 실험을 그림으로 따라갑니다.
고정 엣지와 조건부 엣지의 차이, 분류 노드와 라우팅 함수의 역할 분리, 구조화 출력으로 분류 값을 묶는 방법을 정리하고, conditional.py 를 실제로 실행한 결과와 물음표 규칙 대 모델 분류의 비교표를 담았습니다.
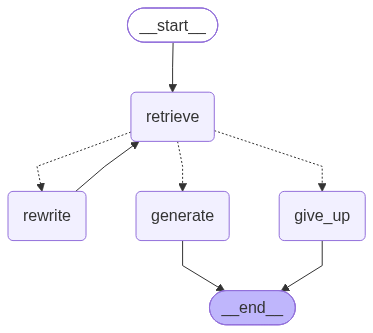
조건부 엣지가 이전 노드 이름을 돌려주는 것이 곧 사이클이라는 점, 코드 한도와 recursion_limit 의 두 겹 종료 장치, 가짜 generate 로 사이클을 재현한 시뮬레이션 결과를 정리했습니다. 품질 기준 200자, 시도 한도 3이던 이전 버전의 cycle.py 를 기준으로 작성된 자료입니다.
while 문으로 돌린 ReAct 루프의 구조와 구성 요소를 설명하고, 실제 실행 뒤의 messages 기록 7개를 번호와 함께 보여 줍니다. 실서비스 전에 고칠 점과, 루프의 각 부분이 LangGraph의 무엇에 대응되는지 표로 정리했습니다.
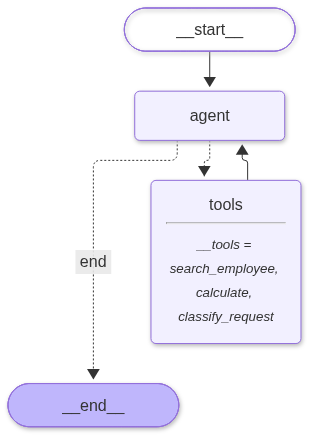
수동 루프와 그래프의 대응표, 구성 요소 넷(State, agent, should_continue, ToolNode)과 도구 셋의 설명, 질문 세 개를 실제로 돌린 실행 기록, 주의할 점을 한 장에 정리했습니다. 실행부가 없던 이전 버전의 파일을 기준으로 작성돼, 구조도 저장 코드의 위치 같은 일부 설명은 지금 파일과 다릅니다.
질문 하나가 graph.stream() 안에서 어떤 노드를 거치는지, 그리고 step마다 State의 messages 가 어떻게 한 칸씩 쌓이는지를 그린 흐름도입니다. agent 가 쓰는 llm_with_tools 와 도구 안쪽에서 쓰는 llm 을 구분해 보여 줍니다.
같은 파이프라인을 노드 검색, 두 노드 사이 경로 추적, 테마 전환, 이미지 내보내기가 되는 탐색형 다이어그램으로 만든 자료입니다. 파일이 약 850KB로 무거워 여는 데 시간이 조금 걸립니다.
day3_practice 폴더의 함수, 클래스, 설명 자료 속 개념을 점 168개와 선 298개로 연결하고 11개 묶음으로 색을 나눈 탐색형 그래프입니다. 점을 누르면 그 항목의 정보가 보이고, 묶음별로 켜고 끌 수 있습니다.


tools_basic.py 의 @tool 세 단계와 tool_error.py 의 네 갈래를 코드와 함께 한 단계씩 넘겨 봅니다. 단계마다 도구 객체의 이름·설명·스키마와, Bedrock 모델 호출에 실리는 toolSpec 을 실제로 변환해 얻은 값으로 나란히 보여 줍니다.
tool_calls 두 건이 ToolNode 에서 ToolMessage 두 개로 돌아오는 과정, divide 의 0 나누기가 handle_tool_errors 설정마다 어떻게 처리되는지, trace.py 가 messages 를 표로 찍는 방식을 코드와 messages 상태를 함께 넘기며 봅니다. 모델의 답은 예시이고, 도구 결과와 에러 문구는 같은 도구로 ToolNode 를 직접 돌려 얻은 값입니다.
Agent, MCP 클라이언트, stdio, MCP 서버, 데이터 파일 사이의 메시지 왕복을 시퀀스 그림과 단계별 플레이어로 따라갑니다. mcp_server.py 의 도구 등록부터 mcp_verify.py 의 initialize, tools/list, tools/call, mcp_agent.py 의 도구 변환과 호출마다 새 세션, 외부 서버와 공공 API 서버까지 다룹니다. JSON-RPC 메시지는 모양만 보인 예시입니다.
일반 백엔드의 재시도·폴백 코드와 이 실습의 차이, 실행 여섯 단계, timeout 모드에서 누가 누구를 부르는지의 시퀀스 그림, 장애 3종 비교표, 이 설계의 약점까지 한 장에 모은 자료입니다. 강의 중 초기 버전 코드를 기준으로 만들어 현재 파일과 세부가 조금 다릅니다.
create_agent 의 루프에서 before_model, after_model, wrap_model_call, wrap_tool_call 이 끼는 자리를 그림과 실제 코드, State 의 메시지, 터미널 출력으로 함께 넘겨 봅니다. A, B, C 세 미들웨어의 실행 순서, 로깅(읽기만)과 마스킹(같은 id 로 교체)의 차이, 요약 미들웨어가 메시지를 줄이는 시점을 탭별로 따라갑니다.
그래프 구조와 invoke 두 번의 관계, main() 의 실행 순서, interrupt 가 두 번 불리는 규칙, yes / no 실행 결과, 체크포인터가 없을 때의 동작을 한 페이지로 정리한 자료입니다. 결재 워크플로의 승인 대기 상태에 빗대어 설명합니다.
같은 내용을 게임 세이브 파일에 빗대어 아주 쉽게 푼 버전입니다. 비유는 쉽지만 checkpoints / writes 두 테이블의 실제 실행 화면과 checkpoint_id 의 구조까지 가장 깊이 열어 보는 자료이기도 합니다.
재생 버튼을 누르면 그래프, 소스 코드, State 의 메시지, 터미널 출력이 한 단계씩 함께 움직입니다. 승인 / 수정 / 거절과 규정 조회 시나리오를 실제 실행 결과로 따라가고, 세 갈래의 ToolMessage 를 표로 비교합니다.
공격 문장과 정상 문장이 규칙 검사, LLM 판별, 출력 가드 중 어느 층에서 걸리거나 통과하는지 실제 코드와 검사 상태, 감사 로그와 함께 한 단계씩 따라갑니다. 규칙을 빠져나가는 공격, 응답의 개인정보 마스킹, 공격·정상 세트 채점도 탭으로 볼 수 있습니다.
에이전트 내부 그래프, 관련 소스 파일, State, 터미널 출력이 한 단계씩 함께 움직이는 플레이어입니다. 세 시나리오를 실제 실행 결과로 따라가고, 미들웨어 부품표와 실제 실행 순서, 직접 만든 gate 와 내장 HITL 미들웨어의 비교, 돌려 보고 찾은 주의점을 정리했습니다.
체크포인터가 thread 단위로 쌓는 대화 원문과 사용자 단위로 별도 테이블에 적는 기억을 한 그림에 놓고, checkpointer_basic, sqlite_chat, memory_chat, auto_memory 를 한 단계씩 따라갑니다. 새 대화방에서 기억만 system 프롬프트로 따라오고 원문은 따라오지 않는 과정을 볼 수 있습니다.
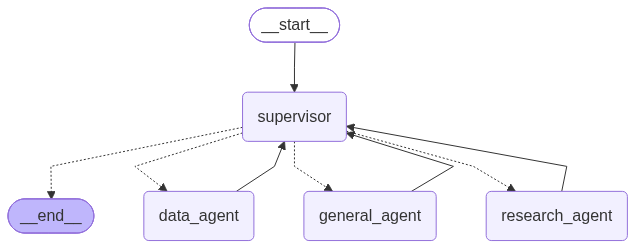
single_agent_problem.py 의 도구 혼동, router_only.py 의 Route 구조화 출력, two_agent_supervisor.py 에서 질문 하나가 supervisor, transfer_to_data_agent, data_agent 를 거쳐 복귀 메시지 한 쌍과 함께 돌아오기까지를 14단계 플레이어로 보여 줍니다. 단계마다 실제 코드 줄과 바깥, 안쪽 messages 가 함께 움직이며, 모델이 쓴 글은 예시입니다.
solo_test 네 번이 각각 어떤 에이전트를 부르고, 그 에이전트가 모델과 도구를 몇 번 불렀는지를 실제 실행 기록으로 그린 자료입니다. 단계별 플레이어로 호출 순서를 따라갈 수 있습니다. 자료를 만든 뒤 파일의 모델 ID가 바뀌었으므로 본문의 모델 표기는 현재 코드와 다릅니다.
질문 하나가 run()에서 supervisor, handoff, data_agent, 도구를 거쳐 최종 답으로 돌아오기까지를 시퀀스 다이어그램과 단계별 플레이어로 보여 줍니다. 바깥 그래프의 State와 서브 에이전트 안쪽 State가 따로 쌓이는 모습, run() 출력에 같은 줄이 두 번 나오는 이유, 실제 호출 횟수와 토큰이 정리돼 있습니다.
만능 에이전트의 혼동에서 Supervisor 배분 검증까지 여섯 단계를 한 장으로 묶은 자료입니다. 검증 질문 네 개의 기대와 실제, 질문별 콜 시퀀스, 복합 질문이 어긋나는 원인 네 가지와 고칠 방향, 점검표 적용 결과, 실행하며 겪은 운영 메모가 들어 있습니다.
파일이 실행되는 순서를 따라 부품이 조립되는 과정과 질문 하나가 에이전트들을 거치는 과정을 구조도, 실행 흐름도, 시퀀스 다이어그램, 단계별 플레이어로 보여 줍니다. 실제 실행에서 기록한 호출 순서와 토큰이 들어 있습니다. LLMLogger 를 넣기 전의 파일을 기준으로 만든 자료라 본문의 줄 번호는 현재 파일과 다릅니다.
supervisor_assembled.py, hierarchical_demo.py, network_demo.py 의 구조도를 나란히 놓고, 각 파일의 질문이 Supervisor, 계층, Network(Swarm) 에서 어떤 노드를 거치는지 탭과 단계별 플레이어로 보여 줍니다. 층마다 올라가는 마지막 메시지, Swarm 의 active_agent 변화, 94줄 주석과 질문이 어긋나는 점, api_server.py 로 그래프를 내보내는 방법을 함께 정리했습니다. 모델이 쓴 글과 고른 경로는 예시입니다.

plan_and_execute.py 의 노드 4개와 엣지 5개를 그림으로 그리고, 각 노드가 State의 어느 칸에 무엇을 쓰는지, 3단계 계획의 실행 순서, 빈 계획과 recursion_limit 같은 주의점을 한 페이지에 모은 자료입니다.
long_term_memory.py 를 14단계로 따라가며 put, get, search 가 Store 에 무엇을 남기는지, chat_node 가 user_id 로 프로필을 읽어 system 메시지에 넣는 과정, thread-1 과 thread-2 의 체크포인터는 따로인데 같은 기억이 실리는 이유를 코드와 상태로 함께 보여 줍니다.
FileTracer 의 각 메서드가 언제 불려 trace.jsonl 에 무엇을 남기는지, run_id 로 시작과 끝을 짝짓는 _starts, 콜백은 받지만 파일에는 남지 않는 부모 관계와 복귀를 14단계 타임라인으로 보여 주고, 6일차 LLMLogger 와도 비교합니다.
run_eval.py 가 fact, paraphrase, no_answer, single_tool, multi_tool, no_tool, guardrail, multi_agent 문항을 각각 어떤 경로로 판정하는지 저장된 eval_result.json 의 실제 값으로 보여 주고, 집계와 DoD 판정, 아직 연결되지 않은 llm_judge 와 integration_check 까지 단계별로 다룹니다.