흐름도
hello_graph 흐름도
그래프 구조, State가 바뀌는 과정, 코드와 그림의 대응을 한 장에 정리한 자료입니다. 노드가 respond 하나뿐이던 초기 버전을 기준으로 만든 것이라 지금 파일(노드 3개)보다 단순하지만, 설계도 → compile → invoke 의 뼈대는 같습니다.
새 탭으로day3_practice/hello_graph_flow.html
체인은 앞으로만 흐릅니다. 결과를 보고 갈라지고, 되돌아가고, 다시 시도하는 흐름을 적으려면 그래프가 필요하고, 그 그래프의 가장 유명한 모양이 ReAct 에이전트입니다.
3일차는 1일차에 while 문으로 돌렸던 도구 호출 루프를 LangGraph의 그래프로 옮기는 날입니다. 먼저 체인만으로는 '실패하면 앞으로 돌아가라'를 적을 수 없다는 것을 확인하고, 그래프를 이루는 세 가지(State, 노드, 엣지)와 값을 합치는 규칙(reducer), 조건부 엣지, 사이클을 하나씩 따로 익힙니다. 마지막에 이 부품들을 모아 '모델 노드 + 도구 노드 + 조건부 엣지 + 사이클'로 된 ReAct 에이전트를 조립합니다. 4일차 이후의 도구, 메모리, 승인, 멀티 에이전트는 전부 이 그래프에 무언가를 덧붙이는 이야기입니다.
compile / invoke / stream 으로 실행한다add_messages)을 구분한다add_conditional_edges 와 라우팅 함수로 분기와 루프를 만들고, 루프에 종료 장치를 둔다stream_mode="updates" 로 에이전트가 어떤 노드를 거쳐 답에 이르는지 한 단계씩 추적한다1~2일차에 만든 체인은 prompt | llm | parser 처럼 왼쪽에서 오른쪽으로 한 번 흐르고 끝났습니다. 그런데 1일차 도구 호출에서 이미 본 것처럼, 에이전트는 "모델을 부른다 → 도구를 실행한다 → 다시 모델을 부른다"를 반복합니다. 이 반복을 체인 바깥의 while 문이 아니라 프로그램의 구조 자체로 적게 해 주는 라이브러리가 LangGraph입니다.
LangGraph에서 프로그램은 그래프입니다. 여기서 그래프는 차트가 아니라 "점(노드)과 그 사이를 잇는 선(엣지)"이라는 자료 구조를 말합니다. 익혀야 할 것은 세 가지뿐입니다.
그래프가 실행되는 동안 모든 노드가 함께 읽고 쓰는 데이터 한 덩어리입니다. 어떤 칸이 있는지는 미리 클래스로 선언합니다.
일을 하는 파이썬 함수입니다. State를 받아서, 바꾸고 싶은 칸만 dict로 돌려줍니다. 모델 호출도, 도구 실행도 노드 안에서 일어납니다.
"이 노드가 끝나면 다음은 어디인가"를 정합니다. 고정된 엣지와, State를 보고 실행 중에 목적지를 고르는 조건부 엣지가 있습니다.
하루의 흐름은 다음과 같습니다. 앞의 여섯 칸은 부품을 하나씩 따로 익히는 연습이고, 뒤의 두 칸이 그 부품으로 에이전트를 조립하는 본론입니다.
| 체인 (LCEL) | 그래프 (LangGraph) | |
|---|---|---|
| 흐름의 모양 | 한 줄. 앞 부품의 출력이 뒤 부품의 입력 | 노드와 엣지. 갈라질 수도, 되돌아갈 수도 있음 |
| 데이터가 다니는 방식 | 부품에서 부품으로 값 하나를 넘김 | 모든 노드가 State 하나를 공유하고, 각자 필요한 칸만 고침 |
| 다음 단계를 정하는 것 | 코드를 쓸 때 | 로 고정 | 고정 엣지 또는 실행 중에 State를 읽는 라우팅 함수 |
| 반복 | 체인 안에 적을 수 없음. 바깥에 while 문 | 이미 지나온 노드로 가는 엣지를 그으면 그것이 반복 |
| 어울리는 일 | 번역, 요약, RAG처럼 순서가 정해진 일 | 결과를 보고 다음 행동이 달라지는 일. 에이전트 |
그래프의 노드 안에서는 여전히 llm.invoke(...) 를 부르고 1일차의 메시지 클래스를 씁니다. LangGraph는 LangChain 부품들 사이의 흐름을 맡는 한 겹 위의 도구입니다. 순서가 고정된 일에는 체인이 여전히 더 짧고 읽기 쉽습니다.
새 도구를 배우기 전에, 지금 가진 도구로 무엇이 안 되는지를 먼저 봅니다. 2일차의 RAG 체인에 요구 사항 하나를 더해 보겠습니다. "검색 결과가 없으면 질문을 바꿔서 다시 찾아라."
chain_limit.py 는 이 실험을 위해 모델을 부르지 않는 가짜 부품 세 개로 2일차와 같은 모양의 체인(검색 → 프롬프트 조립 → 생성)을 만듭니다. 모델을 쓰면 실행마다 답이 달라져 무엇 때문에 막히는지가 흐려지기 때문에, 누가 돌려도 같은 결과가 나오게 한 것입니다.
13def retrieve(question: str) -> dict:
14    """2일차 retriever 자리입니다.
15    진짜 벡터 검색 대신, 질문에 '재택'이라는 말이 있을 때만
16    문서를 찾았다고 치는 가짜 검색기입니다."""
17    if "재택" in question:
18        found = ["재택근무는 주 2회까지 가능하다."]   # 검색 성공
19    else:
20        found = []                                    # 검색 실패: 관련 문서를 못 찾음
21    print(f"  [retrieve] 질문={question!r} -> 문서 {len(found)}건")
22    return {"question": question, "docs": found}
23
24
25def build_prompt(data: dict) -> dict:
26    """2일차 prompt 자리입니다. 찾은 문서를 문자열 하나로 합칩니다."""
27    context = "\n".join(data["docs"]) if data["docs"] else "(근거 문서 없음)"
28    return {"question": data["question"], "context": context}
29
30
31def generate(data: dict) -> str:
32    """2일차 llm 자리입니다. 근거가 없으면 모른다고 답하도록 흉내만 냅니다."""
33    if data["context"] == "(근거 문서 없음)":
34        return "죄송합니다. 관련 규정을 찾지 못했습니다."
35    return f"답변: {data['context']}"
38# ---------- 2) 부품을 체인으로 잇습니다. 2일차와 같은 모양입니다 ----------
39# retrieve -> build_prompt -> generate 로 왼쪽에서 오른쪽으로 한 번 흐릅니다.
40chain = RunnableLambda(retrieve) | RunnableLambda(build_prompt) | RunnableLambda(generate)
41
42
43# ---------- 3) 검색이 실패하는 질문을 넣어 봅니다 ----------
44# '재택'이라는 말이 없으므로 retrieve가 빈손으로 돌아옵니다.
45print("[1] 체인을 한 번 실행합니다")
46print("  결과:", chain.invoke("집에서 일해도 되나요?"))
"집에서 일해도 되나요?"에는 '재택'이라는 말이 없으므로 검색이 빈손으로 돌아오고, 체인은 그대로 "찾지 못했습니다"를 냅니다. 여기까지는 체인이 잘못한 것이 없습니다. 문제는 "그러면 질문을 바꿔 다시 찾아라"를 어디에 적느냐입니다.
A | B | C 에서 | 사이에 놓을 수 있는 것은 다음에 실행할 부품뿐입니다. "C의 결과가 나쁘면 A로 돌아가라"는 문장을 넣을 칸이 문법에 없습니다.
체인을 통째로 감싸는 while 문을 체인 바깥에 둡니다. 다시 찾을지 판단하는 코드와 반복하는 코드가 모두 체인 밖에 삽니다.
60question = "집에서 일해도 되나요?"
61alternatives = ["재택근무 규정", "재택근무 며칠"]   # 바꿔서 다시 물어볼 질문 후보
62attempt = 0
63
64answer = chain.invoke(question)                    # 첫 시도
65
66while "찾지 못했습니다" in answer and attempt < len(alternatives):
67    question = alternatives[attempt]               # 질문을 바꾸고
68    attempt += 1
69    print(f"  [바깥 루프] {attempt}번째 재시도 -> 질문을 {question!r} 로 바꿉니다")
70    answer = chain.invoke(question)                # 체인을 처음부터 다시 실행
71
72print(f"\n최종 답변: {answer}")
73print(f"재시도 횟수: {attempt}")
이 파일은 모델을 부르지 않으므로 직접 실행해 확인했습니다. 첫 실행은 실패하고, 바깥 루프가 질문을 '재택근무 규정'으로 바꾼 뒤에야 문서를 찾습니다.
 1[1] 체인을 한 번 실행합니다
 2  [retrieve] 질문='집에서 일해도 되나요?' -> 문서 0건
 3  결과: 죄송합니다. 관련 규정을 찾지 못했습니다.
 4
 5[2] 재검색을 넣으려면 체인 바깥에 루프를 둬야 합니다
 6  [retrieve] 질문='집에서 일해도 되나요?' -> 문서 0건
 7  [바깥 루프] 1번째 재시도 -> 질문을 '재택근무 규정' 로 바꿉니다
 8  [retrieve] 질문='재택근무 규정' -> 문서 1건
 9
10최종 답변: 답변: 재택근무는 주 2회까지 가능하다.
11재시도 횟수: 1
12
13[관찰] 다시 찾을지 말지를 판단하는 코드와 반복하는 코드가
14       chain 안에 있습니까, 이 파일의 while 문 안에 있습니까?
동작은 합니다. 하지만 흐름의 핵심(언제 되돌아가고 언제 멈추는가)이 체인의 정의가 아니라 흩어진 제어문 속에 숨습니다. 요구가 하나씩 늘 때마다 이 while 문에 if가 붙고, 재시도 횟수 같은 값은 attempt, question 같은 지역 변수로 떠돕니다. 이 구조로는 다음 일들이 어렵습니다.
LangGraph는 이 세 가지를 뒤집습니다. 떠돌던 지역 변수는 State가 되고, while 문의 조건은 조건부 엣지가 되고, "처음으로 돌아가기"는 되돌아가는 엣지가 됩니다. 같은 문제를 그래프로 다시 푼 답안이 뒤의 분기와 루프를 한 그래프에 절에 있습니다.
 1# chain_limit.py - 체인에는 되돌아가기를 적을 자리가 없다는 것을 확인합니다.
 2#
 3# 이 파일은 LLM을 부르지 않습니다. 모델을 부르면 실행할 때마다 답이 달라져서
 4# 무엇 때문에 막히는지가 잘 안 보이기 때문입니다.
 5# 그래서 검색과 생성을 흉내만 내는 함수 세 개로 2일차와 같은 모양의 체인을 만듭니다.
 6# 누가 돌려도 결과가 똑같이 나옵니다.
 7
 8from langchain_core.runnables import RunnableLambda
 9
10
11# ---------- 1) 체인에 끼울 부품 세 개를 만듭니다 ----------
12
13def retrieve(question: str) -> dict:
14    """2일차 retriever 자리입니다.
15    진짜 벡터 검색 대신, 질문에 '재택'이라는 말이 있을 때만
16    문서를 찾았다고 치는 가짜 검색기입니다."""
17    if "재택" in question:
18        found = ["재택근무는 주 2회까지 가능하다."]   # 검색 성공
19    else:
20        found = []                                    # 검색 실패: 관련 문서를 못 찾음
21    print(f"  [retrieve] 질문={question!r} -> 문서 {len(found)}건")
22    return {"question": question, "docs": found}
23
24
25def build_prompt(data: dict) -> dict:
26    """2일차 prompt 자리입니다. 찾은 문서를 문자열 하나로 합칩니다."""
27    context = "\n".join(data["docs"]) if data["docs"] else "(근거 문서 없음)"
28    return {"question": data["question"], "context": context}
29
30
31def generate(data: dict) -> str:
32    """2일차 llm 자리입니다. 근거가 없으면 모른다고 답하도록 흉내만 냅니다."""
33    if data["context"] == "(근거 문서 없음)":
34        return "죄송합니다. 관련 규정을 찾지 못했습니다."
35    return f"답변: {data['context']}"
36
37
38# ---------- 2) 부품을 체인으로 잇습니다. 2일차와 같은 모양입니다 ----------
39# retrieve -> build_prompt -> generate 로 왼쪽에서 오른쪽으로 한 번 흐릅니다.
40chain = RunnableLambda(retrieve) | RunnableLambda(build_prompt) | RunnableLambda(generate)
41
42
43# ---------- 3) 검색이 실패하는 질문을 넣어 봅니다 ----------
44# '재택'이라는 말이 없으므로 retrieve가 빈손으로 돌아옵니다.
45print("[1] 체인을 한 번 실행합니다")
46print("  결과:", chain.invoke("집에서 일해도 되나요?"))
47
48
49# ---------- 4) 여기서 요구가 하나 늘어납니다 ----------
50# "검색 결과가 없으면 질문을 바꿔서 다시 찾아라."
51#
52# 이 지시를 위의 chain 안에 적을 수 있을까요? 적을 칸이 없습니다.
53# chain은 부품을 | 로 이어 붙인 파이프라서, 사이에 놓을 수 있는 것은
54# 다음에 실행할 부품뿐입니다. "실패했으면 앞으로 돌아가라"를 넣을 자리가 없습니다.
55#
56# 그래서 아래처럼 체인 바깥에 while 루프를 따로 둘 수밖에 없습니다.
57
58print("\n[2] 재검색을 넣으려면 체인 바깥에 루프를 둬야 합니다")
59
60question = "집에서 일해도 되나요?"
61alternatives = ["재택근무 규정", "재택근무 며칠"]   # 바꿔서 다시 물어볼 질문 후보
62attempt = 0
63
64answer = chain.invoke(question)                    # 첫 시도
65
66while "찾지 못했습니다" in answer and attempt < len(alternatives):
67    question = alternatives[attempt]               # 질문을 바꾸고
68    attempt += 1
69    print(f"  [바깥 루프] {attempt}번째 재시도 -> 질문을 {question!r} 로 바꿉니다")
70    answer = chain.invoke(question)                # 체인을 처음부터 다시 실행
71
72print(f"\n최종 답변: {answer}")
73print(f"재시도 횟수: {attempt}")
74
75# ---------- 5) 무엇을 봐야 하는지 ----------
76print("\n[관찰] 다시 찾을지 말지를 판단하는 코드와 반복하는 코드가")
77print("       chain 안에 있습니까, 이 파일의 while 문 안에 있습니까?")
그래프를 만들 때 가장 먼저 하는 일은 흐름을 그리는 것이 아니라 "실행 중에 어떤 데이터를 들고 다닐 것인가"를 정하는 것입니다. 이 데이터의 모양을 선언한 것이 State 스키마입니다.
체인에서는 앞 부품의 출력이 곧 뒤 부품의 입력이었습니다. 그래서 세 번째 부품이 첫 번째 부품의 결과를 쓰려면 두 번째 부품이 그 값을 일부러 실어 날라야 했습니다(chain_limit.py 의 build_prompt 가 question 을 그대로 다시 내보내는 것이 그 예입니다). 그래프에서는 모든 노드가 같은 State를 보므로 이런 전달 코드가 필요 없습니다.
 2from typing import TypedDict
 3
 4
 5class State(TypedDict):
 6    user_input: str   # 사용자가 넣는 입력
 7    response: str     # 그래프가 채울 응답
 8    search_quality: bool
 9
10
11initial: State = {"user_input": "안녕하세요", "response": "", "search_quality": False}
12print(initial)
13print(type(initial))   # 실행 시점에는 그냥 dict입니다
TypedDict 는 "이 dict에는 이런 키가 이런 타입으로 들어 있다"를 적는 파이썬 표준 타입 힌트입니다. 클래스처럼 보이지만 객체를 만들어 주지는 않습니다.
1{'user_input': '안녕하세요', 'response': '', 'search_quality': False}
2<class 'dict'>
두 번째 줄이 요점입니다. State 라는 이름은 타입 검사기와 LangGraph에게 "어떤 칸이 있는가"를 알려 주는 설계도이고, 실제로 노드 사이를 오가는 값은 평범한 dict입니다. 그래서 노드 안에서는 state["user_input"] 처럼 dict 문법으로 읽습니다.
| State에 넣는 것 | 이 날의 예 |
|---|---|
| 바깥에서 들어오는 입력 | user_input, question |
| 노드가 만들어 다음 노드에 넘기는 중간 결과 | word_count, docs, intent |
| 분기나 종료를 판단하는 데 쓰는 값 | attempts, quality_score, attempt |
| 최종 결과 | response, answer |
| 대화 기록 | messages (에이전트의 State는 이 칸 하나뿐입니다) |
TypedDict 는 파이썬이 실행 중에 타입을 확인하는 장치가 아닙니다. search_quality 에 문자열을 넣어도 파이썬은 오류를 내지 않습니다. 또 이 날 실습에는 State, ChatState, ClassifyState, QualityState, AgentState 처럼 파일마다 따로 선언한 State가 나옵니다. state_schema.py, hello_graph.py, branch_loop_graph.py 의 클래스는 이름이 모두 State 지만 칸이 서로 다른 별개의 클래스입니다.
 1# state_schema.py - State 스키마 정의
 2from typing import TypedDict
 3
 4
 5class State(TypedDict):
 6    user_input: str   # 사용자가 넣는 입력
 7    response: str     # 그래프가 채울 응답
 8    search_quality: bool
 9
10
11initial: State = {"user_input": "안녕하세요", "response": "", "search_quality": False}
12print(initial)
13print(type(initial))   # 실행 시점에는 그냥 dict입니다
State를 정했으면 그 위에서 일할 노드를 만들고, 엣지로 순서를 잇고, 실행 가능한 객체로 바꿉니다. hello_graph.py 는 분기도 반복도 없는 일자형 그래프로 이 네 단계를 보여 줍니다. 모델도 부르지 않습니다.
 6class State(TypedDict):
 7    user_input: str
 8    word_count: int
 9    response: str
10
11
12def clean(state: State) -> dict:
13    """앞뒤 공백과 연속 공백을 정리합니다. 이미 있는 user_input을 덮어씁니다."""
14    print(f"  [clean]   받은 State: {state}")
15    cleaned = " ".join(state["user_input"].split())
16    return {"user_input": cleaned}
17
18
19def count(state: State) -> dict:
20    """단어 수를 세서 새 키 word_count를 추가합니다."""
21    print(f"  [count]   받은 State: {state}")
22    return {"word_count": len(state["user_input"].split())}
23
24
25def respond(state: State) -> dict:
26    """앞 노드들이 만든 값을 모아 답변을 만듭니다."""
27    print(f"  [respond] 받은 State: {state}")
28    user = state["user_input"]
29    return {"response": f"입력하신 내용은 '{user}' 이고, 단어 {state['word_count']}개입니다."}
노드 함수의 규칙은 두 가지입니다.
respond 는 clean 이 정리한 user_input 과 count 가 만든 word_count 를 둘 다 읽습니다. 앞 노드가 값을 실어 날라 주지 않아도 됩니다.count 는 {"word_count": ...} 만 돌려줍니다. State 전체를 복사해 돌려주는 것이 아닙니다. LangGraph가 이 dict를 기존 State에 합쳐 줍니다.32builder = StateGraph(State) 33builder.add_node("clean", clean) 34builder.add_node("count", count) 35builder.add_node("respond", respond) 36builder.add_edge(START, "clean") 37builder.add_edge("clean", "count") 38builder.add_edge("count", "respond") 39builder.add_edge("respond", END) 40 41graph = builder.compile() # 그래프를 실행 가능한 객체로 변환
| 코드 | 하는 일 |
|---|---|
StateGraph(State) | "이 그래프의 노드들은 State 모양의 데이터를 공유한다"고 선언하며 빈 설계도(builder)를 만듭니다 |
add_node("clean", clean) | 함수에 이름을 붙여 노드로 등록합니다. 엣지와 라우팅 함수는 이 이름 문자열로 노드를 가리킵니다 |
add_edge("clean", "count") | "clean이 끝나면 다음은 항상 count"라는 고정 엣지를 긋습니다 |
START, END | 실제 함수가 아니라 시작점과 끝점을 뜻하는 특별한 이름입니다. START 에서 나가는 엣지가 첫 노드를 정하고, END 로 들어가는 엣지가 종료를 뜻합니다 |
builder.compile() | 설계도를 실행 가능한 객체로 바꿉니다. 이 객체는 1일차의 체인과 마찬가지로 invoke, stream 으로 실행합니다 |
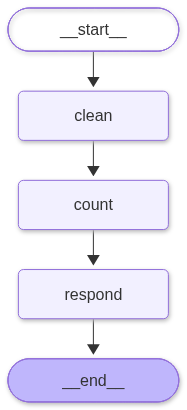
invoke 는 끝까지 실행한 뒤 마지막 State만 돌려줍니다. 중간 과정을 보려면 stream 을 쓰고, 무엇을 받을지를 stream_mode 로 고릅니다.
44if __name__ == "__main__":   # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다
45    # invoke 전에는 State 값이 없습니다. State는 데이터 모양(타입)일 뿐이고, 값은 실행할 때 생깁니다
46    user_input = "  안녕하세요    랭그래프   "
47
48    # 1) 단계마다 State 전체 (노드 안의 print는 '받은 State', 여기는 '노드 실행 뒤 State')
49    print("[values] 단계마다 State 전체")
50    for i, step in enumerate(graph.stream({"user_input": user_input}, stream_mode="values")):
51        print(f"{i}단계 뒤 State: {step}\n")
52
53    # 2) 단계마다 노드가 돌려준 값만
54    print("[updates] 단계마다 노드가 돌려준 값만")
55    for step in graph.stream({"user_input": user_input}, stream_mode="updates"):
56        print(f"  돌려준 값: {step}")
57
58    # 3) invoke는 마지막 State만 돌려줍니다
59    print("\n[invoke] 최종 State")
60    result = graph.invoke({"user_input": user_input})
61    print(result)
| 실행 방법 | 받는 것 | 어울리는 상황 |
|---|---|---|
graph.invoke(입력) | 실행이 끝난 뒤의 최종 State 전체 | 결과만 필요할 때 |
graph.stream(입력, stream_mode="values") | 단계가 끝날 때마다 그 시점의 State 전체. 맨 처음에는 입력만 들어 있는 State가 한 번 나옵니다 | State가 어떻게 자라는지 통째로 보고 싶을 때 |
graph.stream(입력, stream_mode="updates") | 단계가 끝날 때마다 {노드 이름: 그 노드가 돌려준 dict} | 어느 노드가 무엇을 바꿨는지 추적할 때. 이 날 뒤쪽의 실행 추적은 전부 이 모드입니다 |
아래는 이 파일의 실행부를 PNG 저장 줄만 빼고 그대로 돌린 출력입니다(모델을 부르지 않아 누가 돌려도 같습니다). 노드 안의 print 는 "노드가 받은 State", 바깥의 print 는 "노드가 끝난 뒤의 State"입니다.
 1[values] 단계마다 State 전체
 20단계 뒤 State: {'user_input': '  안녕하세요    랭그래프   '}
 3
 4  [clean]   받은 State: {'user_input': '  안녕하세요    랭그래프   '}
 51단계 뒤 State: {'user_input': '안녕하세요 랭그래프'}
 6
 7  [count]   받은 State: {'user_input': '안녕하세요 랭그래프'}
 82단계 뒤 State: {'user_input': '안녕하세요 랭그래프', 'word_count': 2}
 9
10  [respond] 받은 State: {'user_input': '안녕하세요 랭그래프', 'word_count': 2}
113단계 뒤 State: {'user_input': '안녕하세요 랭그래프', 'word_count': 2, 'response': "입력하신 내용은 '안녕하세요 랭그래프' 이고, 단어 2개입니다."}
12
13[updates] 단계마다 노드가 돌려준 값만
14  [clean]   받은 State: {'user_input': '  안녕하세요    랭그래프   '}
15  돌려준 값: {'clean': {'user_input': '안녕하세요 랭그래프'}}
16  [count]   받은 State: {'user_input': '안녕하세요 랭그래프'}
17  돌려준 값: {'count': {'word_count': 2}}
18  [respond] 받은 State: {'user_input': '안녕하세요 랭그래프', 'word_count': 2}
19  돌려준 값: {'respond': {'response': "입력하신 내용은 '안녕하세요 랭그래프' 이고, 단어 2개입니다."}}
20
21[invoke] 최종 State
22  [clean]   받은 State: {'user_input': '  안녕하세요    랭그래프   '}
23  [count]   받은 State: {'user_input': '안녕하세요 랭그래프'}
24  [respond] 받은 State: {'user_input': '안녕하세요 랭그래프', 'word_count': 2}
25{'user_input': '안녕하세요 랭그래프', 'word_count': 2, 'response': "입력하신 내용은 '안녕하세요 랭그래프' 이고, 단어 2개입니다."}
출력에서 읽어 낼 것은 세 가지입니다.
clean 이 user_input 을 돌려주자 공백이 섞인 원래 값이 정리된 값으로 바뀌었습니다. 원래 값은 State에 남지 않습니다.word_count 는 count 가 끝난 뒤에야 State에 나타납니다. 입력에 넣지 않은 칸은 누군가 써 주기 전까지 State에 존재하지 않으므로, 뒤 노드가 state["word_count"] 로 읽으려면 그 값을 쓰는 노드가 반드시 먼저 실행돼야 합니다.invoke 의 반환값은 답변 문자열이 아니라 State 전체입니다. 필요한 값은 result["response"] 처럼 꺼내 씁니다.파일 끝의 graph.get_graph().draw_mermaid_png(output_file_path="hello_graph.png") 가 위 그림을 만듭니다. PNG를 만들 수 없는 환경에서는 예외가 나므로 try/except 로 감싸고, 실패하면 draw_mermaid() 로 같은 구조를 Mermaid 문법의 글자로 출력하게 해 두었습니다. 그림은 조립이 의도대로 됐는지 확인하는 가장 빠른 방법입니다.
63    # 구조 시각화: PNG 저장이 안 되는 환경도 있으므로 try/except로 감쌉니다
64    try:
65        graph.get_graph().draw_mermaid_png(output_file_path="hello_graph.png")
66        print("\nhello_graph.png 저장 완료")
67    except Exception as e:
68        print("\nPNG 저장은 건너뜁니다:", e)
69        print(graph.get_graph().draw_mermaid())   # 텍스트 출력으로 대체
그래프 구조, State가 바뀌는 과정, 코드와 그림의 대응을 한 장에 정리한 자료입니다. 노드가 respond 하나뿐이던 초기 버전을 기준으로 만든 것이라 지금 파일(노드 3개)보다 단순하지만, 설계도 → compile → invoke 의 뼈대는 같습니다.
hello_graph.png 를 새로 저장합니다. 실행부가 if __name__ == "__main__": 아래에 있는 이유는 LangGraph 개발 서버 절에서 설명합니다.1# hello_graph.py - 노드 3개를 이어서 State가 바뀌는 과정 보기 2from typing import TypedDict 3from langgraph.graph import StateGraph, START, END 4 5 6class State(TypedDict): 7 user_input: str 8 word_count: int 9 response: str 10 11 12def clean(state: State) -> dict: 13 """앞뒤 공백과 연속 공백을 정리합니다. 이미 있는 user_input을 덮어씁니다.""" 14 print(f" [clean] 받은 State: {state}") 15 cleaned = " ".join(state["user_input"].split()) 16 return {"user_input": cleaned} 17 18 19def count(state: State) -> dict: 20 """단어 수를 세서 새 키 word_count를 추가합니다.""" 21 print(f" [count] 받은 State: {state}") 22 return {"word_count": len(state["user_input"].split())} 23 24 25def respond(state: State) -> dict: 26 """앞 노드들이 만든 값을 모아 답변을 만듭니다.""" 27 print(f" [respond] 받은 State: {state}") 28 user = state["user_input"] 29 return {"response": f"입력하신 내용은 '{user}' 이고, 단어 {state['word_count']}개입니다."} 30 31 32builder = StateGraph(State) 33builder.add_node("clean", clean) 34builder.add_node("count", count) 35builder.add_node("respond", respond) 36builder.add_edge(START, "clean") 37builder.add_edge("clean", "count") 38builder.add_edge("count", "respond") 39builder.add_edge("respond", END) 40 41graph = builder.compile() # 그래프를 실행 가능한 객체로 변환 42 43 44if __name__ == "__main__": # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다 45 # invoke 전에는 State 값이 없습니다. State는 데이터 모양(타입)일 뿐이고, 값은 실행할 때 생깁니다 46 user_input = " 안녕하세요 랭그래프 " 47 48 # 1) 단계마다 State 전체 (노드 안의 print는 '받은 State', 여기는 '노드 실행 뒤 State') 49 print("[values] 단계마다 State 전체") 50 for i, step in enumerate(graph.stream({"user_input": user_input}, stream_mode="values")): 51 print(f"{i}단계 뒤 State: {step}\n") 52 53 # 2) 단계마다 노드가 돌려준 값만 54 print("[updates] 단계마다 노드가 돌려준 값만") 55 for step in graph.stream({"user_input": user_input}, stream_mode="updates"): 56 print(f" 돌려준 값: {step}") 57 58 # 3) invoke는 마지막 State만 돌려줍니다 59 print("\n[invoke] 최종 State") 60 result = graph.invoke({"user_input": user_input}) 61 print(result) 62 63 # 구조 시각화: PNG 저장이 안 되는 환경도 있으므로 try/except로 감쌉니다 64 try: 65 graph.get_graph().draw_mermaid_png(output_file_path="hello_graph.png") 66 print("\nhello_graph.png 저장 완료") 67 except Exception as e: 68 print("\nPNG 저장은 건너뜁니다:", e) 69 print(graph.get_graph().draw_mermaid()) # 텍스트 출력으로 대체
앞 절에서 노드가 이미 있는 키를 돌려주면 값이 덮어써진다는 것을 봤습니다. 대부분의 칸은 그래도 괜찮습니다. 하지만 대화 기록은 다릅니다. 새 메시지가 올 때마다 앞의 대화가 지워지면 에이전트는 방금 무슨 질문을 받았는지도 잊습니다.
"노드가 돌려준 값을 기존 값과 어떻게 합칠 것인가"를 칸마다 정하는 함수가 reducer입니다. reducer는 (기존 값, 새 값)을 받아 합친 값을 돌려주는 함수이고, State를 선언할 때 타입 옆에 붙여 둡니다.
 8class ChatState(TypedDict):
 9    messages: Annotated[list, add_messages]
10
11
12def chat(state: ChatState) -> dict:
13    # 새 메시지를 리스트로 반환만 하면 add_messages가 알아서 누적합니다
14    return {"messages": [AIMessage(content="안녕하세요, 반갑습니다.")]}
15
16
17builder = StateGraph(ChatState)
18builder.add_node("chat", chat)
19builder.add_edge(START, "chat")
20builder.add_edge("chat", END)
21graph = builder.compile()
Annotated[타입, 부가정보] 는 타입 힌트에 메모를 덧붙이는 파이썬 표준 문법입니다. LangGraph는 이 메모 자리에 놓인 함수를 그 칸의 reducer로 사용합니다. add_messages 는 LangGraph가 대화 기록용으로 미리 만들어 둔 reducer입니다.
messages: list노드가 {"messages": [AI 응답]} 을 돌려주면 리스트가 통째로 교체됩니다. 사용자의 질문이 사라지고 AI 응답 하나만 남습니다.
Annotated[list, add_messages]같은 값을 돌려줘도 기존 리스트 뒤에 붙습니다. 노드는 "새로 생긴 메시지"만 신경 쓰면 되고, 누적은 reducer가 합니다.
24if __name__ == "__main__":   # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다
25    # 1차 실행
26    result = graph.invoke({"messages": [HumanMessage(content="안녕하세요?")]})
27    print("1차 실행 후 메시지 개수:", len(result["messages"]))
28
29    # 2차 실행: 이전 messages를 그대로 이어서 넘기면 계속 누적됩니다
30    result2 = graph.invoke(
31        {"messages": result["messages"] + [HumanMessage(content="잘 지내시나요?")]}
32    )
33    print("2차 실행 후 메시지 개수:", len(result2["messages"]))
34    for m in result2["messages"]:
35        print(f"  [{type(m).__name__}] {m.content}")
11차 실행 후 메시지 개수: 2
22차 실행 후 메시지 개수: 4
3  [HumanMessage] 안녕하세요?
4  [AIMessage] 안녕하세요, 반갑습니다.
5  [HumanMessage] 잘 지내시나요?
6  [AIMessage] 안녕하세요, 반갑습니다.
1차 실행은 입력 1개에 노드의 응답 1개가 붙어 2개가 됐습니다. 2차 실행은 우리가 넣은 3개(1차 결과 2개 + 새 질문 1개)에 응답 1개가 붙어 4개입니다. 이 실습의 chat 노드는 모델을 부르지 않고 항상 같은 문장을 돌려주므로, 관찰 대상은 내용이 아니라 개수입니다.
같은 구조의 작은 그래프에서 messages: list 로만 선언해 돌려 보면 결과의 메시지는 AIMessage 1개뿐입니다. 입력으로 넣은 질문이 사라집니다. 아래 설명 자료에 이 실험이 그림으로 정리돼 있습니다.
add_messages 는 단순한 리스트 덧셈이 아닙니다. 직접 확인한 동작 두 가지를 알아 두면 뒤의 날들이 쉬워집니다.
id 의 메시지는 붙이지 않고 교체합니다. 기존에 id="x1" 인 메시지가 있을 때 같은 id 의 새 메시지를 돌려주면 개수는 그대로이고 내용만 바뀝니다. 기록을 고치거나 줄이는 기능들이 이 성질 위에 서 있습니다.{"role": "user", "content": "..."} 를 넣으면 HumanMessage 가 되고, id 가 없는 메시지에는 id 가 붙습니다.1차 실행과 2차 실행은 서로 무관합니다. 그래프는 실행이 끝나면 State를 기억하지 않습니다. 2차 실행의 기록이 이어진 것은 코드 31번째 줄에서 result["messages"] 를 우리가 다시 넣어 줬기 때문입니다. 1일차의 멀티턴에서 리스트를 직접 들고 다닌 것과 같은 원리입니다. 실행이 끝나도 State를 저장해 두었다가 이어 주는 장치가 5일차의 체크포인터입니다.
reducer가 없을 때(덮어쓰기)와 add_messages 를 붙였을 때(이어 쓰기)를 나란히 놓고, reducer.py 의 1차·2차 실행에서 메시지가 2개, 4개로 쌓이는 과정과 add_messages 를 뺐을 때 질문이 사라지는 실험을 그림으로 따라갑니다.
chat 노드는 고정된 AIMessage 를 돌려주는 가짜 노드입니다. 모델 호출이 없어 자격 증명 없이 실행됩니다.1# reducer.py - add_messages reducer 동작 확인 2from typing import TypedDict, Annotated 3from langgraph.graph import StateGraph, START, END 4from langgraph.graph.message import add_messages 5from langchain_core.messages import HumanMessage, AIMessage 6 7 8class ChatState(TypedDict): 9 messages: Annotated[list, add_messages] 10 11 12def chat(state: ChatState) -> dict: 13 # 새 메시지를 리스트로 반환만 하면 add_messages가 알아서 누적합니다 14 return {"messages": [AIMessage(content="안녕하세요, 반갑습니다.")]} 15 16 17builder = StateGraph(ChatState) 18builder.add_node("chat", chat) 19builder.add_edge(START, "chat") 20builder.add_edge("chat", END) 21graph = builder.compile() 22 23 24if __name__ == "__main__": # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다 25 # 1차 실행 26 result = graph.invoke({"messages": [HumanMessage(content="안녕하세요?")]}) 27 print("1차 실행 후 메시지 개수:", len(result["messages"])) 28 29 # 2차 실행: 이전 messages를 그대로 이어서 넘기면 계속 누적됩니다 30 result2 = graph.invoke( 31 {"messages": result["messages"] + [HumanMessage(content="잘 지내시나요?")]} 32 ) 33 print("2차 실행 후 메시지 개수:", len(result2["messages"])) 34 for m in result2["messages"]: 35 print(f" [{type(m).__name__}] {m.content}")
add_edge 로 그은 엣지는 코드를 쓸 때 목적지가 정해집니다. 조건부 엣지는 출발 노드가 끝난 뒤에 State를 보고 목적지를 정합니다. 그래프가 체인과 달라지는 첫 지점입니다.
conditional.py 는 입력 문장이 답을 원하는 질문인지 감탄이나 소감인지 가려서, 질문이면 모델로 답하고 감탄이면 모델 없이 정해진 반응을 돌려줍니다.
분기에는 두 가지 역할이 있고, 이 파일은 둘을 나눠 놓았습니다.
classify모델에게 물어 "question" 또는 "exclaim" 을 얻고 {"intent": ...} 로 돌려줍니다. 노드이므로 State를 바꿉니다. 판단 결과가 State에 기록으로 남습니다.
route_by_intentState의 intent 를 읽고 다음 노드의 이름을 문자열로 돌려줍니다. 노드가 아니므로 State를 바꾸지 못하고, stream_mode="updates" 에도 나타나지 않습니다.
52def answer_question(state: ClassifyState) -> dict:
53    """질문에 LLM으로 답합니다."""
54    response = llm.invoke(f"다음 질문에 한 줄로 답하세요: {state['user_input']}")
55    return {"response": get_text(response)}
56
57
58def react_exclaim(state: ClassifyState) -> dict:
59    """감탄에는 LLM 없이 정해진 반응을 합니다."""
60    return {"response": f"'{state['user_input']}' 라니 멋진 일이네요."}
61
62
63def route_by_intent(state: ClassifyState) -> Literal["answer_question", "react_exclaim"]:
64    """라우팅 함수: State를 보고 다음 노드의 이름을 반환합니다."""
65    if state["intent"] == "question":
66        return "answer_question"
67    return "react_exclaim"
70builder = StateGraph(ClassifyState)
71builder.add_node("classify", classify)
72builder.add_node("answer_question", answer_question)
73builder.add_node("react_exclaim", react_exclaim)
74
75builder.add_edge(START, "classify")
76builder.add_conditional_edges("classify", route_by_intent)   # 분기 등록
77builder.add_edge("answer_question", END)
78builder.add_edge("react_exclaim", END)
79graph = builder.compile()
동작은 같습니다. 하지만 노드에서 intent 를 State에 적어 두면 최종 결과에 "왜 이 길로 갔는지"가 남습니다. 이 파일의 실행부가 result['intent'] 를 함께 출력할 수 있는 것도 그 덕분입니다. 또 분류 방식을 바꿀 때 고칠 곳이 classify 한 군데로 모입니다.
라우팅 함수는 state["intent"] == "question" 처럼 정확한 문자열을 기대합니다. 모델이 "질문입니다"나 "Question"처럼 답하면 분기가 틀어집니다. 그래서 분류 결과를 자유로운 글이 아니라 허용 값이 정해진 구조로 받습니다.
15# 분류 결과 스키마 - Literal로 두 값 중 하나만 나오도록 강제합니다
16class Intent(BaseModel):
17    intent: Literal["question", "exclaim"] = Field(
18        description="답을 원하는 질문이면 'question', 감탄이나 소감이면 'exclaim'"
19    )
20
21
22# 분류는 매번 같은 답이 나와야 하므로 temperature=0으로 따로 둡니다
23classifier = ChatBedrockConverse(
24    model="us.anthropic.claude-sonnet-4-5-20250929-v1:0",
25    region_name="us-east-1",
26    temperature=0,
27).with_structured_output(Intent)
38class ClassifyState(TypedDict):
39    user_input: str
40    intent: str
41    response: str
42
43
44def classify(state: ClassifyState) -> dict:
45    """LLM이 입력을 보고 question / exclaim 중 하나로 분류합니다. 물음표 유무와 무관합니다."""
46    result = classifier.invoke(
47        f"다음 문장이 답을 원하는 질문인지, 감탄이나 소감인지 분류하세요: {state['user_input']}"
48    )
49    return {"intent": result.intent}
Literal["question", "exclaim"]: 이 칸에는 두 문자열 중 하나만 올 수 있다는 타입입니다. 1일차의 JsonOutputParser가 프롬프트로 형식을 "부탁"했다면, with_structured_output 은 스키마 자체를 모델에 전달해 그 모양으로 답하게 합니다.Field(description=...): 모델에게 전달되는 분류 기준입니다. 기준을 바꾸려면 이 문장을 고칩니다.temperature=0 인 분류 전용 모델: 답변용 llm 과 따로 만들었습니다. 같은 입력이 실행마다 다른 길로 가는 일을 줄이기 위해서입니다.이 날의 여러 파일에 같은 get_text 함수가 반복됩니다. 주석이 설명하듯 ChatBedrockConverse 는 응답의 content 를 문자열이 아니라 블록의 리스트로 주기도 합니다. 그래서 리스트이면 각 블록의 text 만 모아 붙이고, 문자열이면 그대로 돌려줍니다. 응답을 State의 문자열 칸에 넣기 전에 이 함수를 거칩니다.
실행부의 시험 입력 다섯 개 가운데 마지막 두 개에 붙은 주석이 이 파일의 내력을 알려 줍니다. 처음에는 "문장에 물음표가 있으면 질문"이라는 규칙으로 분류했고, 그 규칙이 틀리는 입력을 일부러 넣어 둔 것입니다.
82if __name__ == "__main__":   # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다
83    for text in [
84        "오늘 사내 식당 메뉴 뭐야?",
85        "와 배포가 한 번에 성공했다",
86        "LangGraph가 뭐야?",
87        "오늘 메뉴 뭐야",         # 물음표 없는 질문 -> 이전 규칙에서는 exclaim으로 오분류
88        "이게 되네?!",            # 물음표 있는 감탄 -> 이전 규칙에서는 question으로 오분류
89    ]:
90        result = graph.invoke({"user_input": text, "intent": "", "response": ""})
91        print(f"입력: {text}")
92        print(f"분류: {result['intent']} / 응답: {result['response']}\n")
| 항목 | 물음표 규칙 | 모델 분류 (지금 코드) |
|---|---|---|
| "오늘 메뉴 뭐야", "이게 되네?!" | 둘 다 오분류 | 뜻을 보고 분류. 설명 자료에 기록된 실행에서는 다섯 입력이 모두 의도대로 분류됐습니다 |
| 입력 한 건당 모델 호출 | 질문 1번(답변), 감탄 0번 | 질문 2번(분류 + 답변), 감탄 1번(분류) |
| 결과가 매번 같은가 | 항상 같음 | temperature=0 이어도 완전히 보장되지는 않음 |
| 실패할 수 있는 지점 | 없음 | 분류 호출이 실패하면 그래프 전체가 실패 |
분류 방식이 규칙에서 모델로 바뀌었어도 route_by_intent 와 그래프 조립 코드는 그대로입니다. 판단을 노드에, 길 안내를 라우팅 함수에 나눠 둔 구조의 이득이 여기서 드러납니다.
라우팅 함수는 실행해 보기 전에는 무엇을 돌려줄지 알 수 없는 평범한 함수입니다. 그래서 구조도를 정확히 그리려면 "이 함수가 갈 수 있는 곳"을 따로 알려 줘야 합니다. 이 날의 네 파일은 서로 다른 방법을 씁니다.
| 파일 | 알려 주는 방법 | 코드 |
|---|---|---|
conditional.py | 라우팅 함수의 반환 타입 힌트 | -> Literal["answer_question", "react_exclaim"] |
branch_loop_graph.py | 세 번째 인자에 노드 이름 리스트 | ["generate", "rewrite", "give_up"] |
react_agent.py | 세 번째 인자에 dict. 라우팅 함수는 라벨을 돌려주고 dict가 라벨을 노드로 바꿉니다 | {"tools": "tools", "end": END} |
cycle.py | 알려 주지 않음 | -> str, 세 번째 인자 없음 |
실행에는 영향이 없습니다. 라우팅 함수가 돌려준 이름의 노드가 존재하기만 하면 그래프는 그리로 갑니다. 하지만 그림은 다릅니다. 이 저장소에 설치된 langgraph 1.2.19에서 cycle.py 와 같은 구조(반환 타입 str, 세 번째 인자 없음)의 작은 그래프를 그려 보니 되돌아가는 엣지가 그림에 빠졌습니다. 반환 타입을 Literal 로 바꾸자 두 목적지가 모두 점선으로 그려졌습니다. 강의 때 만든 설명 자료에는 "갈 수 없는 경로까지 점선으로 그려질 수 있다"고 적혀 있어, 틀리는 모양은 버전에 따라 다른 것으로 보입니다. 어느 쪽이든 구조도를 믿으려면 목적지를 명시해야 합니다.
고정 엣지와 조건부 엣지의 차이, 분류 노드와 라우팅 함수의 역할 분리, 구조화 출력으로 분류 값을 묶는 방법을 정리하고, conditional.py 를 실제로 실행한 결과와 물음표 규칙 대 모델 분류의 비교표를 담았습니다.
 1# conditional.py - 조건부 엣지로 분기하기
 2from typing import TypedDict, Literal
 3from dotenv import load_dotenv
 4from pydantic import BaseModel, Field
 5from langgraph.graph import StateGraph, START, END
 6from langchain_aws import ChatBedrockConverse
 7
 8load_dotenv()
 9llm = ChatBedrockConverse(
10    model="us.anthropic.claude-sonnet-4-5-20250929-v1:0",
11    region_name="us-east-1",
12)
13
14
15# 분류 결과 스키마 - Literal로 두 값 중 하나만 나오도록 강제합니다
16class Intent(BaseModel):
17    intent: Literal["question", "exclaim"] = Field(
18        description="답을 원하는 질문이면 'question', 감탄이나 소감이면 'exclaim'"
19    )
20
21
22# 분류는 매번 같은 답이 나와야 하므로 temperature=0으로 따로 둡니다
23classifier = ChatBedrockConverse(
24    model="us.anthropic.claude-sonnet-4-5-20250929-v1:0",
25    region_name="us-east-1",
26    temperature=0,
27).with_structured_output(Intent)
28
29
30def get_text(message):
31    """ChatBedrockConverse는 content를 블록 리스트로 주기도 하므로 텍스트만 모아 반환합니다."""
32    content = message.content
33    if isinstance(content, list):
34        return "".join(block.get("text", "") for block in content if isinstance(block, dict))
35    return content
36
37
38class ClassifyState(TypedDict):
39    user_input: str
40    intent: str
41    response: str
42
43
44def classify(state: ClassifyState) -> dict:
45    """LLM이 입력을 보고 question / exclaim 중 하나로 분류합니다. 물음표 유무와 무관합니다."""
46    result = classifier.invoke(
47        f"다음 문장이 답을 원하는 질문인지, 감탄이나 소감인지 분류하세요: {state['user_input']}"
48    )
49    return {"intent": result.intent}
50
51
52def answer_question(state: ClassifyState) -> dict:
53    """질문에 LLM으로 답합니다."""
54    response = llm.invoke(f"다음 질문에 한 줄로 답하세요: {state['user_input']}")
55    return {"response": get_text(response)}
56
57
58def react_exclaim(state: ClassifyState) -> dict:
59    """감탄에는 LLM 없이 정해진 반응을 합니다."""
60    return {"response": f"'{state['user_input']}' 라니 멋진 일이네요."}
61
62
63def route_by_intent(state: ClassifyState) -> Literal["answer_question", "react_exclaim"]:
64    """라우팅 함수: State를 보고 다음 노드의 이름을 반환합니다."""
65    if state["intent"] == "question":
66        return "answer_question"
67    return "react_exclaim"
68
69
70builder = StateGraph(ClassifyState)
71builder.add_node("classify", classify)
72builder.add_node("answer_question", answer_question)
73builder.add_node("react_exclaim", react_exclaim)
74
75builder.add_edge(START, "classify")
76builder.add_conditional_edges("classify", route_by_intent)   # 분기 등록
77builder.add_edge("answer_question", END)
78builder.add_edge("react_exclaim", END)
79graph = builder.compile()
80
81
82if __name__ == "__main__":   # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다
83    for text in [
84        "오늘 사내 식당 메뉴 뭐야?",
85        "와 배포가 한 번에 성공했다",
86        "LangGraph가 뭐야?",
87        "오늘 메뉴 뭐야",         # 물음표 없는 질문 -> 이전 규칙에서는 exclaim으로 오분류
88        "이게 되네?!",            # 물음표 있는 감탄 -> 이전 규칙에서는 question으로 오분류
89    ]:
90        result = graph.invoke({"user_input": text, "intent": "", "response": ""})
91        print(f"입력: {text}")
92        print(f"분류: {result['intent']} / 응답: {result['response']}\n")
LangGraph에는 반복문이 따로 없습니다. 조건부 엣지의 라우팅 함수가 이미 지나온 노드의 이름을 돌려주면 그것이 곧 반복입니다. 이렇게 엣지를 따라가다 같은 노드로 돌아오는 구조를 사이클이라고 부릅니다.
cycle.py 는 답변을 생성하고, 품질 점수를 매기고, 점수가 모자라면 생성으로 돌아갑니다.
22class QualityState(TypedDict):
23    question: str
24    answer: str
25    attempts: int
26    quality_score: float
27
28
29def generate(state: QualityState) -> dict:
30    """답변을 생성하고 시도 횟수를 1 올립니다."""
31    response = llm.invoke(
32        f"다음 질문에 200자 이상으로 자세하게 답하세요: {state['question']}"
33    )
34    return {
35        "answer": get_text(response),
36        "attempts": state.get("attempts", 0) + 1,
37    }
38
39
40def check_quality(state: QualityState) -> dict:
41    """품질 평가. 실습용으로 단순하게 길이 기반 점수를 씁니다 (200자면 만점)."""
42    score = min(len(state["answer"]) / 500, 1.0)
43    return {"quality_score": score}
46def route_quality(state: QualityState) -> str:
47    """품질이 좋거나 시도 한도에 도달하면 종료하고 아니면 재시도합니다."""
48    if state["quality_score"] >= 0.8:
49        return END
50    if state["attempts"] >= 10:       # 안전장치: 무한 루프 방지
51        return END
52    return "generate"                # 이전 노드로 돌아감 = 반복
53
54
55builder = StateGraph(QualityState)
56builder.add_node("generate", generate)
57builder.add_node("check_quality", check_quality)
58builder.add_edge(START, "generate")
59builder.add_edge("generate", "check_quality")
60builder.add_conditional_edges("check_quality", route_quality)
61graph = builder.compile()
attempts 는 while 문의 카운터 변수에 해당합니다. generate 가 state.get("attempts", 0) + 1 을 돌려줘 한 바퀴마다 1씩 오릅니다. reducer가 없는 칸이므로 새 값이 옛 값을 덮어씁니다.check_quality 가 quality_score 를 기록하고, route_quality 는 그 값을 읽기만 합니다. 앞 절과 같은 역할 분리입니다."generate" 로 돌려보냅니다.add_edge(..., END) 가 없습니다. 라우팅 함수가 END 를 돌려주지 않으면 그래프는 끝나지 않습니다.check_quality 의 설명글은 "200자면 만점"이라고 적혀 있지만 실제 식은 min(len(state["answer"]) / 500, 1.0) 입니다. 500자가 만점이고, 통과 기준 0.8은 400자 이상에 해당합니다. 200자짜리 답은 0.40점으로 미달입니다. 아래 설명 자료는 기준이 200자, 시도 한도가 3이던 이전 버전을 설명하고 있으며, 그 버전에서는 모델이 첫 시도에 541자를 써서 바로 통과하는 바람에 사이클이 돌지 않았다고 기록돼 있습니다. 지금 파일은 기준을 500자로, 한도를 10으로 올리고 질문에 "한문장으로"를 넣어 두었는데, 반복이 실제로 일어나는 모습을 보려는 조정으로 보입니다.
63if __name__ == "__main__":   # 5번째 세션에서 이 파일을 import해 쓰므로 실행 부분은 가드 아래에 둡니다
64    result = {
65        "question": "LangGraph의 장점을 한문장으로 설명해 주세요",
66        "answer": "",
67        "attempts": 0,
68        "quality_score": 0.0,
69    }
70
71    # invoke 대신 stream으로 돌려 노드가 끝날 때마다 중간 과정을 출력합니다
72    # updates 모드는 노드가 돌려준 값만 주므로 result에 직접 합쳐 최종 State를 만듭니다
73    for step in graph.stream(result, stream_mode="updates"):
74        node, update = next(iter(step.items()))
75        result.update(update)
76        if node == "generate":
77            print(f"[{result['attempts']}회차] generate      -> 답변 {len(update['answer'])}자")
78        elif node == "check_quality":
79            score = update["quality_score"]
80            if score >= 0.8:
81                verdict = "통과, 종료"
82            elif route_quality(result) == END:
83                verdict = "미달이지만 시도 한도, 종료"
84            else:
85                verdict = "미달, 재시도"
86            print(f"[{result['attempts']}회차] check_quality -> 점수 {score:.2f} ({verdict})")
step 은 {노드 이름: 돌려준 dict} 모양이고, next(iter(step.items())) 로 그 한 쌍을 꺼냅니다. 이 State에는 reducer가 붙은 칸이 없어 모든 칸이 덮어쓰기이므로 dict.update 로 합친 결과가 그래프 안의 State와 같습니다. 82번째 줄에서는 route_quality(result) 를 직접 불러 "이번 판정이 종료인가"를 출력용으로 다시 계산합니다. 라우팅 함수가 State를 읽기만 하는 평범한 함수이기 때문에 가능한 일입니다.
 1[1회차] generate      -> 답변 300자
 2[1회차] check_quality -> 점수 0.60 (미달, 재시도)
 3[2회차] generate      -> 답변 450자
 4[2회차] check_quality -> 점수 0.90 (통과, 종료)
 5
 6=== 최종 결과 ===
 7시도 횟수: 2
 8품질 점수: 0.90
 9답변 길이: 450자
10답변 미리보기: ...
사이클이 있는 그래프는 끝나지 않을 수 있습니다. 품질 기준을 끝내 못 넘는 경우가 그렇습니다. 그래서 종료 장치를 둘 둡니다.
| 장치 | 어디에 있나 | 걸렸을 때 |
|---|---|---|
attempts >= 10 | 우리 코드 (route_quality) | 정상 종료합니다. 결과는 기준에 못 미친 마지막 답변입니다 |
recursion_limit | LangGraph | 한 번의 실행에서 밟은 단계 수가 한도를 넘으면 GraphRecursionError 예외를 던집니다. graph.invoke(입력, config={"recursion_limit": N}) 으로 정합니다 |
한 바퀴가 generate 와 check_quality 두 단계이므로 10회 시도는 20단계입니다. 코드 쪽 한도가 먼저 걸리도록 설계하고, recursion_limit 은 라우팅 로직에 버그가 있을 때의 마지막 방어선으로 둡니다.
강의 때 만든 설명 자료들은 기본값을 25단계로 적고 있습니다. 그런데 이 저장소의 .venv 에 설치된 langgraph 1.2.19에서 끝나지 않는 작은 그래프를 돌려 보니 오류 메시지는 Recursion limit of 10007 reached ... 였습니다(소스의 기본값 정의도 10007이고, 환경 변수 LANGGRAPH_DEFAULT_RECURSION_LIMIT 로 바꿀 수 있게 돼 있습니다). 기본값은 버전에 따라 다르고, 1만 단계는 모델을 부르는 그래프에서는 사실상 한도가 없는 것과 같습니다. 사이클이 있는 그래프에는 코드 쪽 한도를 반드시 두고, 프레임워크 한도도 config 로 직접 적어 주는 편이 안전합니다. config={"recursion_limit": 6} 을 주면 6단계를 실행한 뒤 예외가 나는 것까지 확인했습니다.
| 지점 | 지금 코드 | 개선 방향 |
|---|---|---|
| 재시도가 같은 요청의 반복 | generate 는 매번 같은 프롬프트를 보냅니다. 앞선 답이 왜 떨어졌는지 모델은 모릅니다 | State의 이전 답변과 점수를 프롬프트에 넣어 "무엇을 보강하라"고 알려 줍니다 |
| 평가 기준이 길이뿐 | 내용이 틀려도 길면 통과합니다 | 모델 평가자(구조화 출력으로 점수와 이유를 받음)나 규칙 검사를 더합니다. 7일차 평가와 이어집니다 |
| 종료 이유를 구분할 수 없음 | 통과로 끝났는지 한도로 끝났는지 호출한 쪽이 점수를 다시 비교해야 압니다 | State에 종료 사유 칸을 두거나, 한도 종료를 별도 노드로 보냅니다(다음 절의 give_up 노드가 그 예입니다) |
| 앞선 답변이 사라짐 | answer 는 덮어쓰기라 마지막 답만 남습니다 | 이력이 필요하면 리스트 칸에 reducer를 붙여 누적합니다 |
조건부 엣지가 이전 노드 이름을 돌려주는 것이 곧 사이클이라는 점, 코드 한도와 recursion_limit 의 두 겹 종료 장치, 가짜 generate 로 사이클을 재현한 시뮬레이션 결과를 정리했습니다. 품질 기준 200자, 시도 한도 3이던 이전 버전의 cycle.py 를 기준으로 작성된 자료입니다.
langgraph.json 에 등록돼 있어 개발 서버에서도 열립니다.1# cycle.py - 조건을 만족할 때까지 반복하는 그래프 2from typing import TypedDict 3from dotenv import load_dotenv 4from langgraph.graph import StateGraph, START, END 5from langchain_aws import ChatBedrockConverse 6 7load_dotenv() 8llm = ChatBedrockConverse( 9 model="us.anthropic.claude-sonnet-4-5-20250929-v1:0", 10 region_name="us-east-1", 11) 12 13 14def get_text(message): 15 """ChatBedrockConverse는 content를 블록 리스트로 주기도 하므로 텍스트만 모아 반환합니다.""" 16 content = message.content 17 if isinstance(content, list): 18 return "".join(block.get("text", "") for block in content if isinstance(block, dict)) 19 return content 20 21 22class QualityState(TypedDict): 23 question: str 24 answer: str 25 attempts: int 26 quality_score: float 27 28 29def generate(state: QualityState) -> dict: 30 """답변을 생성하고 시도 횟수를 1 올립니다.""" 31 response = llm.invoke( 32 f"다음 질문에 200자 이상으로 자세하게 답하세요: {state['question']}" 33 ) 34 return { 35 "answer": get_text(response), 36 "attempts": state.get("attempts", 0) + 1, 37 } 38 39 40def check_quality(state: QualityState) -> dict: 41 """품질 평가. 실습용으로 단순하게 길이 기반 점수를 씁니다 (200자면 만점).""" 42 score = min(len(state["answer"]) / 500, 1.0) 43 return {"quality_score": score} 44 45 46def route_quality(state: QualityState) -> str: 47 """품질이 좋거나 시도 한도에 도달하면 종료하고 아니면 재시도합니다.""" 48 if state["quality_score"] >= 0.8: 49 return END 50 if state["attempts"] >= 10: # 안전장치: 무한 루프 방지 51 return END 52 return "generate" # 이전 노드로 돌아감 = 반복 53 54 55builder = StateGraph(QualityState) 56builder.add_node("generate", generate) 57builder.add_node("check_quality", check_quality) 58builder.add_edge(START, "generate") 59builder.add_edge("generate", "check_quality") 60builder.add_conditional_edges("check_quality", route_quality) 61graph = builder.compile() 62 63if __name__ == "__main__": # 5번째 세션에서 이 파일을 import해 쓰므로 실행 부분은 가드 아래에 둡니다 64 result = { 65 "question": "LangGraph의 장점을 한문장으로 설명해 주세요", 66 "answer": "", 67 "attempts": 0, 68 "quality_score": 0.0, 69 } 70 71 # invoke 대신 stream으로 돌려 노드가 끝날 때마다 중간 과정을 출력합니다 72 # updates 모드는 노드가 돌려준 값만 주므로 result에 직접 합쳐 최종 State를 만듭니다 73 for step in graph.stream(result, stream_mode="updates"): 74 node, update = next(iter(step.items())) 75 result.update(update) 76 if node == "generate": 77 print(f"[{result['attempts']}회차] generate -> 답변 {len(update['answer'])}자") 78 elif node == "check_quality": 79 score = update["quality_score"] 80 if score >= 0.8: 81 verdict = "통과, 종료" 82 elif route_quality(result) == END: 83 verdict = "미달이지만 시도 한도, 종료" 84 else: 85 verdict = "미달, 재시도" 86 print(f"[{result['attempts']}회차] check_quality -> 점수 {score:.2f} ({verdict})") 87 88 print("\n=== 최종 결과 ===") 89 print(f"시도 횟수: {result['attempts']}") 90 print(f"품질 점수: {result['quality_score']:.2f}") 91 print(f"답변 길이: {len(result['answer'])}자") 92 print(f"답변 미리보기: {result['answer'][:80]}...")
조건부 엣지(분기)와 되돌아가는 엣지(루프)를 익혔으니, 처음의 숙제로 돌아갑니다. chain_limit.py 에서 체인 바깥 while 문에 둘 수밖에 없던 "검색 실패 시 질문을 바꿔 재검색"을 그래프 안으로 옮깁니다.
14class State(TypedDict):
15    question: str
16    alternatives: list[str]   # 바꿔서 다시 물어볼 질문 후보
17    attempt: int              # 재시도 횟수
18    docs: list[str]
19    answer: str
24def retrieve(state: State) -> dict:
25    """가짜 검색기: 질문에 '재택'이 있을 때만 문서를 찾습니다."""
26    q = state["question"]
27    docs = ["재택근무는 주 2회까지 가능하다."] if "재택" in q else []
28    print(f"  [retrieve] 질문={q!r} -> 문서 {len(docs)}건")
29    return {"docs": docs}
30
31
32def rewrite(state: State) -> dict:
33    """질문을 다음 후보로 바꾸고 재시도 횟수를 올립니다."""
34    attempt = state["attempt"]
35    new_q = state["alternatives"][attempt]
36    print(f"  [rewrite]  {attempt + 1}번째 재시도 -> 질문을 {new_q!r} 로 바꿉니다")
37    return {"question": new_q, "attempt": attempt + 1}
38
39
40def generate(state: State) -> dict:
41    print("  [generate] 문서로 답변을 만듭니다")
42    return {"answer": f"답변: {state['docs'][0]}"}
43
44
45def give_up(state: State) -> dict:
46    print("  [give_up]  재시도를 다 써서 포기합니다")
47    return {"answer": "죄송합니다. 관련 규정을 찾지 못했습니다."}
48
49
50# ---------- 분기 함수: 다음에 갈 노드 이름을 돌려줍니다 ----------
51
52def route_after_retrieve(state: State) -> str:
53    if state["docs"]:
54        return "generate"
55    if state["attempt"] < len(state["alternatives"]):
56        return "rewrite"
57    return "give_up"
62builder = StateGraph(State)
63builder.add_node("retrieve", retrieve)
64builder.add_node("rewrite", rewrite)
65builder.add_node("generate", generate)
66builder.add_node("give_up", give_up)
67
68builder.add_edge(START, "retrieve")
69builder.add_conditional_edges(                 # 분기: State를 보고 셋 중 하나로
70    "retrieve",
71    route_after_retrieve,
72    ["generate", "rewrite", "give_up"],
73)
74builder.add_edge("rewrite", "retrieve")        # 루프: 다시 검색으로 되돌아감
75builder.add_edge("generate", END)
76builder.add_edge("give_up", END)
77
78graph = builder.compile()
chain_limit.py (체인 + 바깥 루프) | branch_loop_graph.py (그래프) |
|---|---|
지역 변수 question, alternatives, attempt | State의 칸 |
while "찾지 못했습니다" in answer and attempt < len(alternatives) | 라우팅 함수 route_after_retrieve |
while 본문의 question = alternatives[attempt]; attempt += 1 | rewrite 노드 |
| while 문 처음으로 돌아가기 | add_edge("rewrite", "retrieve") |
| 답변 문자열에 특정 문구가 있는지로 실패를 판단 | state["docs"] 가 비었는지로 판단 |
| 실패해도 생성 단계까지 간 뒤에 되돌아감 (체인 전체를 재실행) | 검색이 실패하면 생성으로 가지 않고 바로 rewrite 로 |
| 포기하는 경우가 따로 드러나지 않음 | give_up 노드로 명시 |
rewrite 는 실행될 때마다 attempt 를 1 올리고, 라우팅 함수는 attempt < len(alternatives) 일 때만 rewrite 로 보냅니다. 후보가 유한하므로 언젠가는 generate 나 give_up 으로 빠집니다. 사이클을 만들 때는 "매 바퀴마다 변하는 값"과 "그 값을 보는 종료 조건"이 짝으로 있는지를 먼저 확인합니다.
 84    cases = [
 85        ("바로 찾음",       "재택근무 며칠 가능해?", ["재택근무 규정"]),
 86        ("두 번 돌고 찾음", "집에서 일해도 되나요?", ["원격 근무 규정", "재택근무 규정"]),
 87        ("끝내 못 찾음",    "집에서 일해도 되나요?", ["원격 근무 규정", "홈오피스 규정"]),
 88    ]
 89
 90    for title, question, alternatives in cases:
 91        print("=" * 60)
 92        print(f"[{title}] 질문={question!r}, 후보={alternatives}")
 93        path = []
 94        final = {}
 95        for step in graph.stream(
 96            {"question": question, "alternatives": alternatives, "attempt": 0, "docs": [], "answer": ""},
 97            stream_mode="updates",
 98        ):
 99            node, update = next(iter(step.items()))
100            path.append(node)
101            final.update(update)
102        print(f"  지나간 경로: START -> {' -> '.join(path)} -> END")
103        print(f"  최종 답변: {final['answer']}")
모델을 부르지 않는 파일이므로, 실행부를 PNG 저장 줄만 빼고 돌린 출력을 그대로 싣습니다. 같은 그래프가 입력에 따라 세 가지 다른 경로를 지납니다.
 1============================================================
 2[바로 찾음] 질문='재택근무 며칠 가능해?', 후보=['재택근무 규정']
 3  [retrieve] 질문='재택근무 며칠 가능해?' -> 문서 1건
 4  [generate] 문서로 답변을 만듭니다
 5  지나간 경로: START -> retrieve -> generate -> END
 6  최종 답변: 답변: 재택근무는 주 2회까지 가능하다.
 7============================================================
 8[두 번 돌고 찾음] 질문='집에서 일해도 되나요?', 후보=['원격 근무 규정', '재택근무 규정']
 9  [retrieve] 질문='집에서 일해도 되나요?' -> 문서 0건
10  [rewrite]  1번째 재시도 -> 질문을 '원격 근무 규정' 로 바꿉니다
11  [retrieve] 질문='원격 근무 규정' -> 문서 0건
12  [rewrite]  2번째 재시도 -> 질문을 '재택근무 규정' 로 바꿉니다
13  [retrieve] 질문='재택근무 규정' -> 문서 1건
14  [generate] 문서로 답변을 만듭니다
15  지나간 경로: START -> retrieve -> rewrite -> retrieve -> rewrite -> retrieve -> generate -> END
16  최종 답변: 답변: 재택근무는 주 2회까지 가능하다.
17============================================================
18[끝내 못 찾음] 질문='집에서 일해도 되나요?', 후보=['원격 근무 규정', '홈오피스 규정']
19  [retrieve] 질문='집에서 일해도 되나요?' -> 문서 0건
20  [rewrite]  1번째 재시도 -> 질문을 '원격 근무 규정' 로 바꿉니다
21  [retrieve] 질문='원격 근무 규정' -> 문서 0건
22  [rewrite]  2번째 재시도 -> 질문을 '홈오피스 규정' 로 바꿉니다
23  [retrieve] 질문='홈오피스 규정' -> 문서 0건
24  [give_up]  재시도를 다 써서 포기합니다
25  지나간 경로: START -> retrieve -> rewrite -> retrieve -> rewrite -> retrieve -> give_up -> END
26  최종 답변: 죄송합니다. 관련 규정을 찾지 못했습니다.
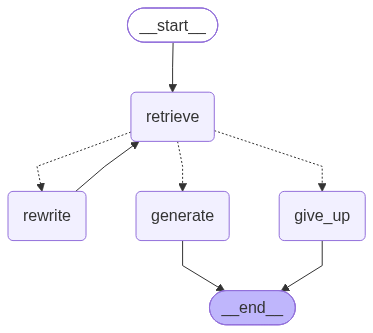
chain_limit.py 의 마지막 질문("판단하는 코드와 반복하는 코드가 어디에 있습니까")에 대한 그래프의 답은 "그래프 안, 라우팅 함수와 엣지에"입니다. 흐름이 그림으로 보이고, 경로가 기록으로 남고, 현재 위치와 값이 State 한곳에 모입니다.
chain_limit.py 의 답안에 해당합니다. 실행하면 branch_loop_graph.png 를 새로 저장합니다.1# branch_loop_graph.py - 분기와 루프가 있는 그래프 2# 3# chain_limit.py에서 체인 바깥 while 문으로 처리했던 "검색 실패 시 질문 바꿔 재검색"을 4# 그래프 안으로 옮깁니다. LLM은 부르지 않으므로 누가 돌려도 결과가 같습니다. 5# 6# START -> retrieve -> (분기) --문서 있음-------------> generate -> END 7# | --문서 없음, 재시도 가능--> rewrite -> retrieve (루프) 8# | --문서 없음, 재시도 끝----> give_up -> END 9 10from typing import TypedDict 11from langgraph.graph import StateGraph, START, END 12 13 14class State(TypedDict): 15 question: str 16 alternatives: list[str] # 바꿔서 다시 물어볼 질문 후보 17 attempt: int # 재시도 횟수 18 docs: list[str] 19 answer: str 20 21 22# ---------- 노드 ---------- 23 24def retrieve(state: State) -> dict: 25 """가짜 검색기: 질문에 '재택'이 있을 때만 문서를 찾습니다.""" 26 q = state["question"] 27 docs = ["재택근무는 주 2회까지 가능하다."] if "재택" in q else [] 28 print(f" [retrieve] 질문={q!r} -> 문서 {len(docs)}건") 29 return {"docs": docs} 30 31 32def rewrite(state: State) -> dict: 33 """질문을 다음 후보로 바꾸고 재시도 횟수를 올립니다.""" 34 attempt = state["attempt"] 35 new_q = state["alternatives"][attempt] 36 print(f" [rewrite] {attempt + 1}번째 재시도 -> 질문을 {new_q!r} 로 바꿉니다") 37 return {"question": new_q, "attempt": attempt + 1} 38 39 40def generate(state: State) -> dict: 41 print(" [generate] 문서로 답변을 만듭니다") 42 return {"answer": f"답변: {state['docs'][0]}"} 43 44 45def give_up(state: State) -> dict: 46 print(" [give_up] 재시도를 다 써서 포기합니다") 47 return {"answer": "죄송합니다. 관련 규정을 찾지 못했습니다."} 48 49 50# ---------- 분기 함수: 다음에 갈 노드 이름을 돌려줍니다 ---------- 51 52def route_after_retrieve(state: State) -> str: 53 if state["docs"]: 54 return "generate" 55 if state["attempt"] < len(state["alternatives"]): 56 return "rewrite" 57 return "give_up" 58 59 60# ---------- 그래프 조립 ---------- 61 62builder = StateGraph(State) 63builder.add_node("retrieve", retrieve) 64builder.add_node("rewrite", rewrite) 65builder.add_node("generate", generate) 66builder.add_node("give_up", give_up) 67 68builder.add_edge(START, "retrieve") 69builder.add_conditional_edges( # 분기: State를 보고 셋 중 하나로 70 "retrieve", 71 route_after_retrieve, 72 ["generate", "rewrite", "give_up"], 73) 74builder.add_edge("rewrite", "retrieve") # 루프: 다시 검색으로 되돌아감 75builder.add_edge("generate", END) 76builder.add_edge("give_up", END) 77 78graph = builder.compile() 79 80 81if __name__ == "__main__": # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다 82 # ---------- 세 가지 경우를 실행해 봅니다 ---------- 83 84 cases = [ 85 ("바로 찾음", "재택근무 며칠 가능해?", ["재택근무 규정"]), 86 ("두 번 돌고 찾음", "집에서 일해도 되나요?", ["원격 근무 규정", "재택근무 규정"]), 87 ("끝내 못 찾음", "집에서 일해도 되나요?", ["원격 근무 규정", "홈오피스 규정"]), 88 ] 89 90 for title, question, alternatives in cases: 91 print("=" * 60) 92 print(f"[{title}] 질문={question!r}, 후보={alternatives}") 93 path = [] 94 final = {} 95 for step in graph.stream( 96 {"question": question, "alternatives": alternatives, "attempt": 0, "docs": [], "answer": ""}, 97 stream_mode="updates", 98 ): 99 node, update = next(iter(step.items())) 100 path.append(node) 101 final.update(update) 102 print(f" 지나간 경로: START -> {' -> '.join(path)} -> END") 103 print(f" 최종 답변: {final['answer']}") 104 105 # 구조 시각화: PNG 저장이 안 되는 환경도 있으므로 try/except로 감쌉니다 106 try: 107 graph.get_graph().draw_mermaid_png(output_file_path="branch_loop_graph.png") 108 print("\nbranch_loop_graph.png 저장 완료") 109 except Exception as e: 110 print("\nPNG 저장은 건너뜁니다:", e) 111 print(graph.get_graph().draw_mermaid()) # 텍스트 출력으로 대체
이제 그래프에 올릴 대상을 봅니다. ReAct는 Reasoning(추론)과 Acting(행동)을 합친 말로, 모델이 무엇을 할지 판단하고 → 도구를 실행하고 → 결과를 관찰한 뒤 → 다시 판단하는 반복을 가리킵니다. 오늘날 "에이전트"라고 부르는 것의 기본 동작이 이 루프입니다.
구조는 1일차 도구 호출 맛보기의 반복문과 같습니다. 그때는 맛보기였고, 여기서는 그래프로 옮기기 직전에 루프의 각 줄이 무슨 역할인지 이름을 붙여 가며 다시 씁니다.
22# ---------- 1) 도구 정의 ----------
23@tool
24def search_employee(name: str) -> str:
25    """임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요."""
26    # 교육용 더미 데이터입니다. 실제 사내 데이터와 무관합니다.
27    employees = {
28        "김하늘": "김하늘 / 클라우드운영팀 / haneul.kim@samsungsds.example.com",
29        "박도윤": "박도윤 / 물류플랫폼팀 / doyun.park@samsungsds.example.com",
30    }
31    return employees.get(name, f"'{name}' 님을 찾을 수 없습니다.")
32
33
34@tool
35def calculate(expression: str) -> str:
36    """수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '34 * 27', '(15 - 5) / 2'"""
37    try:
38        return str(eval(expression, {"__builtins__": {}}, {}))
39    except Exception as e:
40        return f"계산 실패: {e}"
41
42
43tools = [search_employee, calculate]
44tools_by_name = {t.name: t for t in tools}   # 이름으로 도구를 찾기 위한 사전
45
46# ---------- 2) 도구 목록을 모델에 알려주기 ----------
47llm_with_tools = llm.bind_tools(tools)
48
49# ---------- 3) 대화 기록 초기화 ----------
50messages = [
51    SystemMessage(content="너는 삼성SDS 사내 어시스턴트야. 필요하면 도구를 사용해."),
52    HumanMessage(content="김하늘 님과 박도윤 님이 각각 어느 팀 소속인지 알려주고, 34 곱하기 27도 계산해줘."),
53]
@tool: 함수 이름이 도구 이름, 설명글(docstring)이 모델이 읽는 설명서, 타입 힌트가 인자 스키마가 됩니다. 모델은 설명글만 보고 언제 이 도구를 쓸지 정합니다.tools_by_name: 모델은 도구를 이름 문자열로 지목합니다. 그 이름으로 실제 함수를 찾기 위한 dict입니다.llm.bind_tools(tools): 도구 설명서를 매 요청에 함께 보내는 새 모델 객체를 돌려줍니다. 모델은 도구를 실행하지 않고 "이 도구를 이 인자로 불러 달라"는 tool_calls 만 돌려줍니다.messages: system 메시지와 사용자 질문으로 시작하는 평범한 리스트입니다. 질문은 일부러 도구가 세 번 필요한 내용(두 사람 조회 + 계산)으로 골랐습니다.55# ---------- 4) ReAct 루프: 도구 선택 -> 실행 -> 결과 관찰 -> 재판단 ---------- 56MAX_TURNS = 10 # 안전장치 57turn = 0 58while turn < MAX_TURNS: 59 turn += 1 60 ai_message = llm_with_tools.invoke(messages) # (추론) 모델이 도구 필요 여부를 판단 61 messages.append(ai_message) # 응답을 기록에 추가 62 63 if not ai_message.tool_calls: # 도구 요청이 없으면 최종 답변 64 print(f"\n[최종 답변] {get_text(ai_message)}") 65 break 66 67 for tool_call in ai_message.tool_calls: # (행동) 요청된 도구를 전부 실행 68 tool_fn = tools_by_name[tool_call["name"]] 69 result = tool_fn.invoke(tool_call["args"]) 70 print(f"[턴 {turn}] {tool_call['name']}({tool_call['args']}) -> {result}") 71 72 messages.append( # (관찰) 결과를 기록에 추가 73 ToolMessage(content=str(result), tool_call_id=tool_call["id"]) 74 ) 75 # while 처음으로 돌아감 -> 모델이 도구 결과를 보고 다시 판단 (재판단) 76else: 77 print("\n[중단] 최대 턴 수를 초과했습니다.")
messages 전체가 다시 전송됩니다. 응답 ai_message 를 기록에 붙이는 것을 빠뜨리면 다음 턴에서 모델이 자기가 무엇을 요청했는지 알 수 없습니다.break 합니다. 이 한 줄이 루프의 유일한 정상 출구입니다.tool_fn.invoke(tool_call["args"]) 로 실행합니다.tool_call_id=tool_call["id"] 로 어느 요청의 결과인지 짝을 맞춥니다. 요청이 셋이면 ToolMessage도 셋이어야 합니다.while ... else 에서 else 는 break 없이 조건이 거짓이 되어 끝났을 때만 실행됩니다. 그래서 "최종 답변 없이 턴 한도에 걸린 경우"만 따로 잡아 중단 메시지를 냅니다.1[턴 1] search_employee({'name': '김하늘'}) -> 김하늘 / 클라우드운영팀 / haneul.kim@samsungsds.example.com 2[턴 1] search_employee({'name': '박도윤'}) -> 박도윤 / 물류플랫폼팀 / doyun.park@samsungsds.example.com 3[턴 1] calculate({'expression': '34 * 27'}) -> 918 4 5[최종 답변] ...
아래 설명 자료에는 강의 때의 실제 실행 기록이 메시지 번호와 함께 정리돼 있습니다. 그 실행에서 모델은 서로 독립적인 도구 요청 세 개를 한 턴에 한꺼번에 냈고, 모델 호출은 두 번(요청 한 번, 최종 답변 한 번)으로 끝났습니다. 이것은 모델이 정하는 일이라 보장되지 않습니다. 앞 도구의 결과가 다음 도구의 인자가 되는 질문이면 턴이 늘어납니다.
| 지점 | 지금 코드 | 문제와 대응 |
|---|---|---|
| 계산기 | eval(expression, {"__builtins__": {}}, {}) | 모델이 만든 문자열을 eval 에 넣는 것은 내장 함수를 비워도 안전하지 않습니다. 매우 큰 거듭제곱 같은 입력으로 프로세스를 묶을 수 있습니다. 숫자와 사칙연산만 허용하는 파서로 바꿉니다(뒤의 Java 버전이 그렇게 합니다) |
| 도구 찾기 | tools_by_name[tool_call["name"]] | 모델이 없는 이름을 내면 KeyError 로 루프 전체가 죽습니다. 오류 내용을 ToolMessage로 돌려줘 모델이 고치게 합니다 |
| 도구 예외 | calculate 만 try/except 로 실패를 문자열로 돌려줌 | 외부 시스템을 부르는 도구는 실패가 흔합니다. 실패해도 같은 tool_call_id 의 ToolMessage를 반드시 넣어야 다음 호출이 성립합니다. 4일차의 장애 주입 실습이 이 주제입니다 |
| 턴 한도 | MAX_TURNS = 10 | 한도에 걸리면 답 없이 끝납니다. 사용자에게 보낼 대체 응답을 정해 둡니다 |
| 토큰 | 매 턴 messages 전체 전송 | 턴과 도구 결과가 쌓일수록 입력 토큰이 늘어납니다. 긴 도구 결과는 줄여서 넣습니다 |
이 파일은 chain_limit.py 와 같은 처지입니다. 판단(if not ai_message.tool_calls)과 반복(while)이 제어문에 있고, 상태(messages, turn)가 지역 변수입니다. 여기에 "위험한 도구는 실행 전에 사람 승인을 받는다", "중간에 끊겨도 이어서 한다", "다른 에이전트에게 넘긴다"를 넣으려면 while 문 안이 조건문으로 가득 찹니다. 그래프로 옮겨 두면 이런 요구가 노드 하나, 엣지 하나를 더하는 일이 됩니다. 5~6일차가 바로 그 작업입니다.
while 문으로 돌린 ReAct 루프의 구조와 구성 요소를 설명하고, 실제 실행 뒤의 messages 기록 7개를 번호와 함께 보여 줍니다. 실서비스 전에 고칠 점과, 루프의 각 부분이 LangGraph의 무엇에 대응되는지 표로 정리했습니다.
 1# manual_react.py - ReAct 루프를 while 루프로 직접 구현
 2from dotenv import load_dotenv
 3from langchain_aws import ChatBedrockConverse
 4from langchain_core.tools import tool
 5from langchain_core.messages import HumanMessage, SystemMessage, ToolMessage
 6
 7load_dotenv()
 8llm = ChatBedrockConverse(
 9    model="us.anthropic.claude-sonnet-4-5-20250929-v1:0",
10    region_name="us-east-1",
11)
12
13
14def get_text(message):
15    """ChatBedrockConverse는 content를 블록 리스트로 주기도 하므로 텍스트만 모아 반환합니다."""
16    content = message.content
17    if isinstance(content, list):
18        return "".join(block.get("text", "") for block in content if isinstance(block, dict))
19    return content
20
21
22# ---------- 1) 도구 정의 ----------
23@tool
24def search_employee(name: str) -> str:
25    """임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요."""
26    # 교육용 더미 데이터입니다. 실제 사내 데이터와 무관합니다.
27    employees = {
28        "김하늘": "김하늘 / 클라우드운영팀 / haneul.kim@samsungsds.example.com",
29        "박도윤": "박도윤 / 물류플랫폼팀 / doyun.park@samsungsds.example.com",
30    }
31    return employees.get(name, f"'{name}' 님을 찾을 수 없습니다.")
32
33
34@tool
35def calculate(expression: str) -> str:
36    """수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '34 * 27', '(15 - 5) / 2'"""
37    try:
38        return str(eval(expression, {"__builtins__": {}}, {}))
39    except Exception as e:
40        return f"계산 실패: {e}"
41
42
43tools = [search_employee, calculate]
44tools_by_name = {t.name: t for t in tools}   # 이름으로 도구를 찾기 위한 사전
45
46# ---------- 2) 도구 목록을 모델에 알려주기 ----------
47llm_with_tools = llm.bind_tools(tools)
48
49# ---------- 3) 대화 기록 초기화 ----------
50messages = [
51    SystemMessage(content="너는 삼성SDS 사내 어시스턴트야. 필요하면 도구를 사용해."),
52    HumanMessage(content="김하늘 님과 박도윤 님이 각각 어느 팀 소속인지 알려주고, 34 곱하기 27도 계산해줘."),
53]
54
55# ---------- 4) ReAct 루프: 도구 선택 -> 실행 -> 결과 관찰 -> 재판단 ----------
56MAX_TURNS = 10                                     # 안전장치
57turn = 0
58while turn < MAX_TURNS:
59    turn += 1
60    ai_message = llm_with_tools.invoke(messages)   # (추론) 모델이 도구 필요 여부를 판단
61    messages.append(ai_message)                    # 응답을 기록에 추가
62
63    if not ai_message.tool_calls:                  # 도구 요청이 없으면 최종 답변
64        print(f"\n[최종 답변] {get_text(ai_message)}")
65        break
66
67    for tool_call in ai_message.tool_calls:        # (행동) 요청된 도구를 전부 실행
68        tool_fn = tools_by_name[tool_call["name"]]
69        result = tool_fn.invoke(tool_call["args"])
70        print(f"[턴 {turn}] {tool_call['name']}({tool_call['args']}) -> {result}")
71
72        messages.append(                           # (관찰) 결과를 기록에 추가
73            ToolMessage(content=str(result), tool_call_id=tool_call["id"])
74        )
75    # while 처음으로 돌아감 -> 모델이 도구 결과를 보고 다시 판단 (재판단)
76else:
77    print("\n[중단] 최대 턴 수를 초과했습니다.")
수동 루프의 줄 하나하나를 지금까지 익힌 부품으로 바꿉니다. 새로 배울 개념은 없습니다. State + reducer, 노드 둘, 조건부 엣지 하나, 되돌아가는 엣지 하나가 전부입니다.
react_agent.py 의 주석에는 [수동 루프의 ...] -> ... 형식의 표시가 붙어 있습니다. 그것을 모으면 다음 표가 됩니다.
manual_react.py | react_agent.py | 앞에서 익힌 곳 |
|---|---|---|
messages 리스트와 append | AgentState.messages: Annotated[list, add_messages] | reducer |
llm_with_tools.invoke(messages) 와 응답 append | agent 노드가 {"messages": [응답]} 반환 | 노드 |
if not ai_message.tool_calls: break | should_continue + add_conditional_edges | 조건부 엣지 |
for tool_call in ... 실행과 ToolMessage 포장 | 내장 ToolNode(tools) | 오늘 처음 나옴 |
while 처음으로 돌아가기 | add_edge("tools", "agent") | 사이클 |
MAX_TURNS = 10 | 코드에 없음. recursion_limit 에 맡김 | 종료 장치 |
26@tool
27def search_employee(name: str) -> str:
28    """임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요."""
29    # 교육용 더미 데이터입니다. 실제 사내 데이터와 무관합니다.
30    employees = {
31        "김하늘": {"team": "클라우드운영팀", "email": "haneul.kim@samsungsds.example.com"},
32        "박도윤": {"team": "물류플랫폼팀", "email": "doyun.park@samsungsds.example.com"},
33    }
34    if name in employees:
35        e = employees[name]
36        return f"{name} / {e['team']} / {e['email']}"
37    return f"'{name}' 님을 찾을 수 없습니다. 조회 가능한 임직원: {list(employees.keys())}"
38
39
40@tool
41def calculate(expression: str) -> str:
42    """수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '3480000 * 1.1', '48 * 1.12'"""
43    try:
44        return str(eval(expression, {"__builtins__": {}}, {}))
45    except Exception as e:
46        return f"계산 실패: {e}. 수식 형식을 확인하세요."
47
48
49@tool
50def classify_request(text: str) -> str:
51    """사내 문의 문장을 받아 담당 부서를 IT지원, 인사, 총무 중 하나로 분류합니다. 문의 접수와 부서 배정 질문에 사용하세요."""
52    # 도구 안에서 다시 LLM을 호출합니다. 도구 안의 AI입니다.
53    result = llm.invoke(
54        "다음 사내 문의의 담당 부서를 IT지원, 인사, 총무 중 하나로만 답하세요. "
55        f"다른 말은 붙이지 마세요.\n\n문의: {text}"
56    )
57    return get_text(result).strip()
58
59
60tools = [search_employee, calculate, classify_request]
search_employee더미 사전에서 조회합니다. 없는 이름이면 예외를 던지지 않고 조회 가능한 이름 목록을 붙인 문자열을 돌려줍니다. 모델이 사용자에게 상황을 설명하거나 다른 이름으로 다시 시도할 수 있습니다.
calculateeval 로 계산합니다. 실패 메시지에 "수식 형식을 확인하세요"를 덧붙여 모델이 인자를 고쳐 다시 부를 여지를 줍니다. 수동 루프와 같은 eval 이므로 같은 보안 문제가 있습니다.
classify_request문의 문장을 IT지원, 인사, 총무 중 하나로 분류합니다. 이 도구는 안에서 도구가 붙지 않은 llm 을 한 번 더 부릅니다. 에이전트가 보기에는 문자열을 돌려주는 평범한 도구입니다.
64# [수동 루프의 messages 리스트] -> State + add_messages reducer
65class AgentState(TypedDict):
66    messages: Annotated[list, add_messages]
67
68
69SYSTEM_PROMPT = """너는 삼성SDS 사내 AI 어시스턴트야.
70
71[도구 사용 전략]
721. 임직원 정보는 반드시 search_employee로 조회해. 지어내지 마.
732. 계산이 필요하면 calculate를 사용해. 암산하지 마.
743. 사내 문의의 담당 부서 판단은 classify_request를 사용해.
754. 도구가 필요 없는 인사나 일반 질문에는 도구 없이 바로 답해."""
76
77llm_with_tools = llm.bind_tools(tools)
78
79
80# [수동 루프의 invoke와 append] -> agent 노드
81def agent(state: AgentState) -> dict:
82    messages = [SystemMessage(content=SYSTEM_PROMPT)] + state["messages"]
83    return {"messages": [llm_with_tools.invoke(messages)]}
agent 는 호출할 때마다 [SystemMessage(...)] + state["messages"] 를 만들어 보내지만, 돌려주는 것은 모델의 응답뿐입니다. 그래서 State에는 사용자와 모델과 도구가 주고받은 대화만 쌓이고, 지침은 코드의 SYSTEM_PROMPT 한 곳에서 관리됩니다. 지침을 고쳐도 저장된 기록을 건드릴 필요가 없습니다. 수동 루프에서는 messages 리스트의 첫 칸에 SystemMessage가 들어 있던 것과 다른 점입니다.
SYSTEM_PROMPT 의 [도구 사용 전략]은 도구마다 "언제 쓰라"를 한 줄씩 적고, 마지막 줄에서 "도구가 필요 없으면 바로 답하라"고 합니다. 모델이 도구를 고르는 기준은 이 지침과 각 도구의 설명글 두 곳입니다.
 86# [수동 루프의 if not ai_message.tool_calls] -> 라우팅 함수
 87def should_continue(state: AgentState) -> Literal["tools", "end"]:
 88    last = state["messages"][-1]
 89    return "tools" if last.tool_calls else "end"
 90
 91
 92builder = StateGraph(AgentState)
 93builder.add_node("agent", agent)
 94builder.add_node("tools", ToolNode(tools))   # [도구 실행과 ToolMessage 포장] -> 내장 ToolNode
 95
 96builder.add_edge(START, "agent")
 97builder.add_conditional_edges("agent", should_continue, {"tools": "tools", "end": END})
 98builder.add_edge("tools", "agent")           # [while 루프] -> Cycle
 99
100graph = builder.compile()
agent 노드 직후에 불리므로 state["messages"][-1] 은 방금 모델이 낸 AIMessage입니다. 거기에 tool_calls 가 있으면 "tools", 없으면 "end" 를 돌려줍니다.{"tools": "tools", "end": END} 에서 왼쪽은 라우팅 함수가 돌려주는 라벨, 오른쪽은 실제 목적지입니다. 라우팅 함수는 END 를 직접 알 필요 없이 "end" 라는 뜻이 드러나는 라벨만 돌려줍니다.ToolNode(tools) 는 LangGraph가 제공하는 노드입니다. 뒤의 실행 추적 코드가 tools 노드의 반환값에서 name, content, tool_call_id 를 읽는 것에서 알 수 있듯, 요청된 도구들을 실행하고 요청마다 같은 tool_call_id 를 단 ToolMessage를 messages 로 돌려줍니다. 수동 루프의 tools_by_name 조회, 실행, 포장 코드가 이 안으로 들어갔습니다.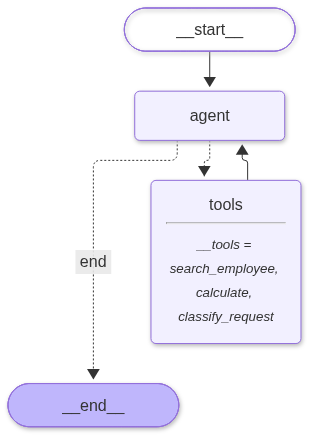
수동 루프의 MAX_TURNS 에 해당하는 코드가 react_agent.py 에는 없습니다. 모델이 도구를 계속 부르면 멈추게 하는 것은 LangGraph의 recursion_limit 뿐인데, 앞 절에서 확인했듯 이 환경의 기본값은 10007단계입니다. agent 와 tools 한 바퀴가 2단계이므로, 한도를 20으로 두면 도구 왕복이 열 번 안쪽에서 멈춥니다. 실서비스라면 graph.invoke(입력, config={"recursion_limit": 20}) 처럼 직접 적고, GraphRecursionError 를 잡아 대체 응답을 내는 처리를 함께 둡니다.
이 날의 다른 파일은 us.anthropic.claude-sonnet-4-5-20250929-v1:0 을 쓰는데 react_agent.py 는 us.anthropic.claude-sonnet-4-6 으로 적혀 있습니다. 1일차에서 본 것처럼 모델 교체는 모델 객체를 만드는 한 줄의 일이고 그래프 코드는 바뀌지 않습니다. 다만 강의 때 만든 다이어그램 자료에는 Sonnet 4.5로 표기된 곳이 있으니 자료와 코드를 맞춰 볼 때 참고하세요.
수동 루프와 그래프의 대응표, 구성 요소 넷(State, agent, should_continue, ToolNode)과 도구 셋의 설명, 질문 세 개를 실제로 돌린 실행 기록, 주의할 점을 한 장에 정리했습니다. 실행부가 없던 이전 버전의 파일을 기준으로 작성돼, 구조도 저장 코드의 위치 같은 일부 설명은 지금 파일과 다릅니다.
질문 하나가 graph.stream() 안에서 어떤 노드를 거치는지, 그리고 step마다 State의 messages 가 어떻게 한 칸씩 쌓이는지를 그린 흐름도입니다. agent 가 쓰는 llm_with_tools 와 도구 안쪽에서 쓰는 llm 을 구분해 보여 줍니다.
같은 파이프라인을 노드 검색, 두 노드 사이 경로 추적, 테마 전환, 이미지 내보내기가 되는 탐색형 다이어그램으로 만든 자료입니다. 파일이 약 850KB로 무거워 여는 데 시간이 조금 걸립니다.
파일 전체는 다음 절의 실행 추적 설명 뒤에 싣습니다.
그래프로 옮긴 덕에 생긴 가장 눈에 띄는 이득은 관찰입니다. 수동 루프에서는 print 문을 루프 곳곳에 심어야 했지만, 그래프는 stream 만 걸면 노드가 끝날 때마다 무슨 일이 있었는지를 내줍니다. react_agent.py 의 3/3 부분이 이 추적 코드입니다.
117    for q in questions:
118        print("\n" + "=" * 70)
119        print(f"질문: {q}")
120        history = [HumanMessage(content=q)]   # State의 messages를 따라가며 보관 (보낸 메시지 수 계산용)
121
122        # stream(updates): 노드가 하나 끝날 때마다 그 노드가 돌려준 값을 받습니다
123        for step_no, step in enumerate(
124            graph.stream({"messages": history[:]}, stream_mode="updates"), start=1
125        ):
126            node, update = next(iter(step.items()))
127            new_messages = update["messages"]
128
129            if node == "agent":
130                ai = new_messages[0]
131                print(f"\n[step {step_no}] agent 노드 -> LLM 호출 "
132                      f"(보낸 메시지: System 1개 + 대화 {len(history)}개)")
133                print(f"  LLM 리턴 타입: {type(ai).__name__}")
134                print(f"  content (원본): {ai.content!r}")
135                if ai.tool_calls:
136                    print(f"  tool_calls {len(ai.tool_calls)}개 -> 다음은 tools 노드")
137                    for tc in ai.tool_calls:
138                        print(f"    - {tc['name']}({tc['args']})  id={tc['id']}")
139                else:
140                    print("  tool_calls 없음 -> END (이게 최종 답변)")
141                if ai.usage_metadata:
142                    u = ai.usage_metadata
143                    print(f"  토큰: 입력 {u['input_tokens']} / 출력 {u['output_tokens']}")
144
145            elif node == "tools":
146                print(f"\n[step {step_no}] tools 노드 -> 도구 {len(new_messages)}개 실행, 결과를 ToolMessage로 반환")
147                for tm in new_messages:
148                    print(f"    - {tm.name} -> {tm.content!r}  (tool_call_id={tm.tool_call_id})")
149                print("  -> 다음은 다시 agent 노드 (사이클)")
150
151            history.extend(new_messages)
152
153        print(f"\n최종 답변:\n{get_text(history[-1])}")
graph.stream({"messages": history[:]}, ...) 로 질문 하나짜리 리스트를 넣습니다. history[:] 는 복사본을 넘기는 표기입니다.update["messages"] 가 그 노드가 새로 만든 메시지들입니다. agent 노드면 AIMessage 하나, tools 노드면 실행한 도구 수만큼의 ToolMessage입니다.history.extend(new_messages) 는 그래프 안에서 add_messages 가 하는 일을 바깥에서 흉내 내는 것입니다. "이번 모델 호출에 메시지가 몇 개 갔는가"를 출력하려고 둔 장부입니다.history[-1] 은 tool_calls 가 없는 AIMessage이고, get_text 로 글만 꺼내 출력합니다.1====================================================================== 2질문: 김하늘 님 소속 팀 알려주고, 연봉 3480000에 10% 인상하면 얼마인지 계산해줘. 3 4[step 1] agent 노드 -> LLM 호출 (보낸 메시지: System 1개 + 대화 1개) 5 LLM 리턴 타입: AIMessage 6 content (원본): ... 7 tool_calls 2개 -> 다음은 tools 노드 8 - search_employee({'name': '김하늘'}) id=... 9 - calculate({'expression': '3480000 * 1.1'}) id=... 10 토큰: 입력 ... / 출력 ... 11 12[step 2] tools 노드 -> 도구 2개 실행, 결과를 ToolMessage로 반환 13 - search_employee -> '김하늘 / 클라우드운영팀 / haneul.kim@samsungsds.example.com' (tool_call_id=...) 14 - calculate -> '3828000.0000000005' (tool_call_id=...) 15 -> 다음은 다시 agent 노드 (사이클) 16 17[step 3] agent 노드 -> LLM 호출 (보낸 메시지: System 1개 + 대화 4개) 18 LLM 리턴 타입: AIMessage 19 content (원본): ... 20 tool_calls 없음 -> END (이게 최종 답변) 21 토큰: 입력 ... / 출력 ... 22 23최종 답변: 24...
| 출력의 어느 부분 | 알 수 있는 것 |
|---|---|
| "대화 1개" → "대화 4개" | 모델 호출마다 기록 전체가 다시 갑니다. 두 번째 호출에는 질문 1개, 도구를 요청한 AIMessage 1개, ToolMessage 2개가 함께 들어갑니다. 입력 토큰 수가 커지는 이유입니다 |
content (원본) | 문자열이 아니라 블록 리스트일 수 있어 !r 로 원래 모양을 그대로 찍습니다. 도구를 요청하는 응답은 글 없이 요청만 담고 있을 수도 있습니다 |
id=... 와 tool_call_id=... | agent 단계의 요청 id와 tools 단계의 결과 id가 짝을 이룹니다. ToolNode가 이 짝 맞추기를 대신했습니다 |
'3828000.0000000005' | 파이썬에서 3480000 * 1.1 의 결과입니다. 도구는 "정확한 계산"을 약속했지만 부동소수 오차는 그대로 돌려줍니다. 금액을 다루는 도구라면 도구 안에서 반올림하거나 십진 연산을 써야 합니다. 모델이 알아서 다듬어 주기를 기대하면 안 됩니다 |
| step 수 | 도구를 한 번에 요청하면 agent → tools → agent 세 단계입니다. 하나씩 요청하면 왕복이 한 번 더 생깁니다 |
두 번째 질문("노트북 화면이 안 켜져요...")에서 모델이 classify_request 를 부르면, 그 도구 안에서 모델 호출이 한 번 더 일어납니다. 하지만 이 추적은 노드 단위로만 출력하므로 화면에는 tools 노드가 문자열 하나를 돌려준 것으로만 보이고, 이 내부 호출의 토큰 수도 찍히지 않습니다. agent 노드가 두 번 돌았다면 실제 모델 호출은 세 번입니다. 비용과 지연을 따질 때 "도구 안의 모델 호출"을 따로 세어야 하는 이유이며, 이런 숨은 호출까지 보여 주는 도구가 7일차의 추적입니다.
react_agent.png 를 새로 저장하고 질문 두 개를 돌립니다. 모델을 부르므로 자격 증명이 필요합니다.1# react_agent.py (1/3) - 도구 준비 2from typing import TypedDict, Annotated, Literal 3from dotenv import load_dotenv 4from langgraph.graph import StateGraph, START, END 5from langgraph.graph.message import add_messages 6from langgraph.prebuilt import ToolNode 7from langchain_aws import ChatBedrockConverse 8from langchain_core.tools import tool 9from langchain_core.messages import HumanMessage, SystemMessage 10 11load_dotenv() 12llm = ChatBedrockConverse( 13 model="us.anthropic.claude-sonnet-4-6", 14 region_name="us-east-1", 15) 16 17 18def get_text(message): 19 """ChatBedrockConverse는 content를 블록 리스트로 주기도 하므로 텍스트만 모아 반환합니다.""" 20 content = message.content 21 if isinstance(content, list): 22 return "".join(block.get("text", "") for block in content if isinstance(block, dict)) 23 return content 24 25 26@tool 27def search_employee(name: str) -> str: 28 """임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요.""" 29 # 교육용 더미 데이터입니다. 실제 사내 데이터와 무관합니다. 30 employees = { 31 "김하늘": {"team": "클라우드운영팀", "email": "haneul.kim@samsungsds.example.com"}, 32 "박도윤": {"team": "물류플랫폼팀", "email": "doyun.park@samsungsds.example.com"}, 33 } 34 if name in employees: 35 e = employees[name] 36 return f"{name} / {e['team']} / {e['email']}" 37 return f"'{name}' 님을 찾을 수 없습니다. 조회 가능한 임직원: {list(employees.keys())}" 38 39 40@tool 41def calculate(expression: str) -> str: 42 """수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '3480000 * 1.1', '48 * 1.12'""" 43 try: 44 return str(eval(expression, {"__builtins__": {}}, {})) 45 except Exception as e: 46 return f"계산 실패: {e}. 수식 형식을 확인하세요." 47 48 49@tool 50def classify_request(text: str) -> str: 51 """사내 문의 문장을 받아 담당 부서를 IT지원, 인사, 총무 중 하나로 분류합니다. 문의 접수와 부서 배정 질문에 사용하세요.""" 52 # 도구 안에서 다시 LLM을 호출합니다. 도구 안의 AI입니다. 53 result = llm.invoke( 54 "다음 사내 문의의 담당 부서를 IT지원, 인사, 총무 중 하나로만 답하세요. " 55 f"다른 말은 붙이지 마세요.\n\n문의: {text}" 56 ) 57 return get_text(result).strip() 58 59 60tools = [search_employee, calculate, classify_request] 61 62# react_agent.py (2/3) - 그래프 조립 63 64# [수동 루프의 messages 리스트] -> State + add_messages reducer 65class AgentState(TypedDict): 66 messages: Annotated[list, add_messages] 67 68 69SYSTEM_PROMPT = """너는 삼성SDS 사내 AI 어시스턴트야. 70 71[도구 사용 전략] 721. 임직원 정보는 반드시 search_employee로 조회해. 지어내지 마. 732. 계산이 필요하면 calculate를 사용해. 암산하지 마. 743. 사내 문의의 담당 부서 판단은 classify_request를 사용해. 754. 도구가 필요 없는 인사나 일반 질문에는 도구 없이 바로 답해.""" 76 77llm_with_tools = llm.bind_tools(tools) 78 79 80# [수동 루프의 invoke와 append] -> agent 노드 81def agent(state: AgentState) -> dict: 82 messages = [SystemMessage(content=SYSTEM_PROMPT)] + state["messages"] 83 return {"messages": [llm_with_tools.invoke(messages)]} 84 85 86# [수동 루프의 if not ai_message.tool_calls] -> 라우팅 함수 87def should_continue(state: AgentState) -> Literal["tools", "end"]: 88 last = state["messages"][-1] 89 return "tools" if last.tool_calls else "end" 90 91 92builder = StateGraph(AgentState) 93builder.add_node("agent", agent) 94builder.add_node("tools", ToolNode(tools)) # [도구 실행과 ToolMessage 포장] -> 내장 ToolNode 95 96builder.add_edge(START, "agent") 97builder.add_conditional_edges("agent", should_continue, {"tools": "tools", "end": END}) 98builder.add_edge("tools", "agent") # [while 루프] -> Cycle 99 100graph = builder.compile() 101 102# react_agent.py (3/3) - 실행하면서 노드마다 무슨 일이 일어나는지 출력 103if __name__ == "__main__": # langgraph dev 서버가 import할 때는 실행되지 않도록 가드 아래에 둡니다 104 # 구조 시각화 (PNG 저장이 안 되는 환경 대비 try/except) 105 try: 106 graph.get_graph().draw_mermaid_png(output_file_path="react_agent.png") 107 print("react_agent.png 저장 완료") 108 except Exception as e: 109 print("PNG 저장은 건너뜁니다:", e) 110 print(graph.get_graph().draw_mermaid()) 111 112 questions = [ 113 "김하늘 님 소속 팀 알려주고, 연봉 3480000에 10% 인상하면 얼마인지 계산해줘.", 114 "노트북 화면이 안 켜져요. 어느 부서에 문의해야 하나요?", 115 ] 116 117 for q in questions: 118 print("\n" + "=" * 70) 119 print(f"질문: {q}") 120 history = [HumanMessage(content=q)] # State의 messages를 따라가며 보관 (보낸 메시지 수 계산용) 121 122 # stream(updates): 노드가 하나 끝날 때마다 그 노드가 돌려준 값을 받습니다 123 for step_no, step in enumerate( 124 graph.stream({"messages": history[:]}, stream_mode="updates"), start=1 125 ): 126 node, update = next(iter(step.items())) 127 new_messages = update["messages"] 128 129 if node == "agent": 130 ai = new_messages[0] 131 print(f"\n[step {step_no}] agent 노드 -> LLM 호출 " 132 f"(보낸 메시지: System 1개 + 대화 {len(history)}개)") 133 print(f" LLM 리턴 타입: {type(ai).__name__}") 134 print(f" content (원본): {ai.content!r}") 135 if ai.tool_calls: 136 print(f" tool_calls {len(ai.tool_calls)}개 -> 다음은 tools 노드") 137 for tc in ai.tool_calls: 138 print(f" - {tc['name']}({tc['args']}) id={tc['id']}") 139 else: 140 print(" tool_calls 없음 -> END (이게 최종 답변)") 141 if ai.usage_metadata: 142 u = ai.usage_metadata 143 print(f" 토큰: 입력 {u['input_tokens']} / 출력 {u['output_tokens']}") 144 145 elif node == "tools": 146 print(f"\n[step {step_no}] tools 노드 -> 도구 {len(new_messages)}개 실행, 결과를 ToolMessage로 반환") 147 for tm in new_messages: 148 print(f" - {tm.name} -> {tm.content!r} (tool_call_id={tm.tool_call_id})") 149 print(" -> 다음은 다시 agent 노드 (사이클)") 150 151 history.extend(new_messages) 152 153 print(f"\n최종 답변:\n{get_text(history[-1])}")
지금까지는 python 파일.py 로 스크립트를 직접 실행했습니다. LangGraph에는 컴파일된 그래프를 서버로 띄워 브라우저(LangGraph Studio)에서 실행해 보는 개발 도구가 있고, langgraph.json 은 그 도구가 읽는 설정 파일입니다.
1{
2  "dependencies": ["."],
3  "graphs": {
4    "react_agent": "./react_agent.py:graph",
5    "cycle": "./cycle.py:graph"
6  },
7  "env": "../.env"
8}
| 항목 | 값 | 뜻 |
|---|---|---|
dependencies | ["."] | 이 폴더(day3_practice/)를 코드가 있는 곳으로 지정합니다 |
graphs | react_agent, cycle | 서버에 등록할 그래프 둘. 각각 react_agent.py 와 cycle.py 의 graph 변수입니다. 다른 파일의 그래프는 등록돼 있지 않습니다 |
env | "../.env" | 환경 변수를 읽을 파일. 레포 루트의 .env 를 가리킵니다 |
개발 서버는 LangGraph CLI의 langgraph dev 명령으로 띄웁니다. 이 저장소의 .venv 에는 langgraph-cli 가 설치돼 있고, day3_practice/ 아래에는 개발 서버가 남기는 것으로 보이는 .langgraph_api/ 폴더가 있습니다. 서버에서 그래프를 실행하면 모델을 실제로 부르므로 스크립트 실행과 똑같이 비용이 듭니다.
이 날의 그래프 파일들은 실행부가 모두 if __name__ == "__main__": 아래에 있고, 대부분 그 옆에 "langgraph dev 서버가 import할 때는 실행되지 않도록"이라는 주석이 달려 있습니다.
서버가 graph 변수를 가져오려고 파일을 import하는 순간, 파일 맨 아래의 실행 코드까지 돌아갑니다. import만 했는데 모델이 불리고 PNG가 저장됩니다.
__name__ 은 파일을 직접 실행할 때만 "__main__" 입니다. import될 때는 그래프 정의(graph = builder.compile())까지만 실행되고 시험 코드는 건너뜁니다.
이 구분은 서버가 아니어도 쓸모가 있습니다. cycle.py 의 주석은 다른 세션에서 이 파일을 import해 쓴다고 적고 있고, 설명 자료의 사이클 시뮬레이션도 cycle.py 의 check_quality 와 route_quality 를 import해서 만들었습니다. 그래프를 정의하는 부분과 시험 삼아 돌려 보는 부분을 나눠 두면 같은 그래프를 스크립트, 서버, 다른 파일에서 모두 가져다 쓸 수 있습니다. manual_react.py 와 chain_limit.py 는 가드가 없는 순수한 스크립트라 import하면 곧바로 실행됩니다.
graphs 에 "이름": "./파일.py:변수" 를 추가하는 형식입니다.1{ 2 "dependencies": ["."], 3 "graphs": { 4 "react_agent": "./react_agent.py:graph", 5 "cycle": "./cycle.py:graph" 6 }, 7 "env": "../.env" 8}
ReAct 루프는 LangGraph의 기능이 아니라 모델의 도구 호출 위에 얹는 제어 흐름입니다. 그래서 다른 언어, 다른 프레임워크로도 같은 구조를 만들 수 있습니다. spring_ai_react/ 는 react_agent.py 를 Java와 Spring AI로 옮겨 본 비교용 프로젝트입니다.
소스의 주석에 따르면 Spring AI에는 StateGraph에 해당하는 것이 없어서, 그래프의 각 부품을 메서드로 일대일 대응시켰습니다. 결과물은 그래프라기보다 "그래프의 노드와 엣지에 이름을 붙여 놓은 while 루프"이고, 그 점에서 manual_react.py 와 react_agent.py 의 중간쯤에 있습니다.
68    public String run(String question) {
69        // AgentState.messages. SystemMessage는 여기 넣지 않고 agent()에서 매번 앞에 붙입니다.
70        List<Message> state = new ArrayList<>();
71        state.add(new UserMessage(question));
72
73        int step = 0;
74        while (step < MAX_STEPS) {
75            // ---- agent 노드 ----
76            step++;
77            System.out.printf("%n[step %d] agent 노드 -> LLM 호출 (보낸 메시지: System 1개 + 대화 %d개)%n",
78                    step, state.size());
79            ChatResponse response = agent(state);
80            AssistantMessage ai = response.getResult().getOutput();
81            state.add(ai);                                    // add_messages: append
82            printAgentStep(response, ai);
83
84            // ---- should_continue (조건부 엣지) ----
85            if (!shouldContinue(response)) {
86                return ai.getText();                          // -> END
87            }
88
89            // ---- tools 노드 ----
90            step++;
91            ToolResponseMessage toolMessage = tools(state, response);
92            state.add(toolMessage);                           // add_messages: append
93            printToolsStep(step, toolMessage);
94            // ---- add_edge("tools", "agent"): 루프 처음으로 돌아감 (사이클) ----
95        }
96        throw new IllegalStateException("MAX_STEPS(" + MAX_STEPS + ")를 넘었습니다. 사이클이 끝나지 않습니다.");
97    }
 99    /** agent 노드: [SystemMessage] + state 를 도구 스키마와 함께 LLM에 보냄 */
100    private ChatResponse agent(List<Message> state) {
101        return chatClient.prompt()
102                .system(SYSTEM_PROMPT)
103                .messages(state)
104                .options(chatOptions)
105                .call()
106                .chatResponse();
107    }
108
109    /** should_continue: 마지막 AI 메시지에 tool_calls가 있으면 tools, 없으면 END */
110    private boolean shouldContinue(ChatResponse response) {
111        return response.hasToolCalls();
112    }
113
114    /**
115     * tools 노드 (ToolNode): tool_calls를 실행하고 결과를 ToolResponseMessage로 돌려줌.
116     * executeToolCalls는 "프롬프트 + AI 메시지 + 도구 결과" 전체 히스토리를 돌려주므로
117     * 이번 노드가 새로 만든 마지막 메시지(도구 결과)만 꺼내 state에 append 합니다.
118     * Spring AI는 도구 여러 개의 결과를 ToolResponseMessage 하나에 담습니다
119     * (LangChain은 ToolMessage를 도구마다 하나씩 만드는 점이 다름).
120     */
121    private ToolResponseMessage tools(List<Message> state, ChatResponse response) {
122        Prompt prompt = new Prompt(List.copyOf(state), chatOptions);
123        ToolExecutionResult result = toolCallingManager.executeToolCalls(prompt, response);
124        List<Message> history = result.conversationHistory();
125        return (ToolResponseMessage) history.get(history.size() - 1);
126    }
파이썬 (react_agent.py) | Java (spring_ai_react) | 차이 |
|---|---|---|
AgentState.messages + add_messages | List<Message> state + state.add(...) | reducer가 없으므로 누적을 코드가 직접 합니다 |
agent 노드 | agent(state): chatClient.prompt().system(...).messages(state).options(chatOptions).call() | system 지침을 매번 앞에 붙이고 기록에는 넣지 않는 방식이 같습니다 |
llm.bind_tools(tools) | ToolCallingChatOptions 에 ToolCallbacks.from(agentTools) 를 실어 요청마다 전달 | |
should_continue + 조건부 엣지 | shouldContinue(response) 가 response.hasToolCalls() 를 돌려주고, run() 의 if 문이 분기 | 라우팅 결과가 문자열이 아니라 boolean입니다 |
ToolNode(tools) | tools(state, response) 안의 toolCallingManager.executeToolCalls(...) | 주석에 따르면 Spring AI는 도구 여러 개의 결과를 ToolResponseMessage 하나에 담습니다. LangChain은 도구마다 ToolMessage를 하나씩 만듭니다 |
add_edge("tools", "agent") | run() 의 while 루프 | |
(코드에 없음, recursion_limit 에 맡김) | MAX_STEPS = 10, 넘으면 IllegalStateException | agent와 tools를 각각 한 step으로 세므로 agent의 모델 호출은 최대 다섯 번입니다. 한도를 코드에 직접 적어 둔 점은 수동 루프 쪽과 같습니다 |
@tool 함수와 설명글 | @Tool(description=...) 메서드와 @ToolParam | 도구 이름이 searchEmployee, classifyRequest 처럼 Java 표기로 바뀌어 system 지침 속 이름도 함께 바뀌었습니다 |
eval(expression, ...) | ExpressionCalculator (사칙연산과 괄호만 받는 파서, BigDecimal) | 임의 코드 실행의 여지가 없습니다. 주석은 BigDecimal 이라 3480000 * 1.1 에 부동소수 오차가 생기지 않는다고 설명합니다. 파이썬 쪽이 3828000.0000000005 를 돌려주던 바로 그 계산입니다 |
if __name__ == "__main__": | ReactAgentApplication 의 CommandLineRunner 빈 | 같은 질문 두 개를 돌립니다 |
ChatBedrockConverse(model=..., region_name=...) | application.properties 의 spring.ai.bedrock... 설정 | Java 쪽 모델은 Sonnet 4.5로 적혀 있습니다 |
32    @Tool(description = "임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요.")
33    public String searchEmployee(@ToolParam(description = "임직원 이름. 예: 김하늘") String name) {
34        String[] e = EMPLOYEES.get(name);
35        if (e != null) {
36            return name + " / " + e[0] + " / " + e[1];
37        }
38        return "'" + name + "' 님을 찾을 수 없습니다. 조회 가능한 임직원: " + EMPLOYEES.keySet();
39    }
40
41    @Tool(description = "수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '3480000 * 1.1', '48 * 1.12'")
42    public String calculate(@ToolParam(description = "사칙연산 수식") String expression) {
43        // Python은 eval()을 썼지만 Java에는 eval이 없으므로 작은 파서로 대신합니다.
44        // BigDecimal이라 3480000 * 1.1 = 3828000.0 처럼 부동소수 오차가 없습니다.
45        try {
46            return ExpressionCalculator.evaluate(expression).toPlainString();
47        } catch (RuntimeException e) {
48            return "계산 실패: " + e.getMessage() + ". 수식 형식을 확인하세요.";
49        }
50    }
51
52    @Tool(description = "사내 문의 문장을 받아 담당 부서를 IT지원, 인사, 총무 중 하나로 분류합니다. 문의 접수와 부서 배정 질문에 사용하세요.")
53    public String classifyRequest(@ToolParam(description = "사내 문의 원문") String text) {
54        // 도구 안에서 다시 LLM을 호출합니다. 도구 안의 AI입니다.
55        String result = plainLlm.prompt()
56                .user("다음 사내 문의의 담당 부서를 IT지원, 인사, 총무 중 하나로만 답하세요. "
57                        + "다른 말은 붙이지 마세요.\n\n문의: " + text)
58                .call()
59                .content();
60        return result == null ? "" : result.strip();
61    }
application.properties 의 마지막 줄 spring.ai.chat.client.tool-calling.enabled=false 에는 "ChatClient가 도구 호출 루프를 알아서 돌리지 않게 끈다"는 주석이 달려 있습니다. ReactAgent.java 의 주석은 이 설정을 지우고 .tools(agentTools) 를 붙여 호출하면 Spring AI가 루프 전체를 내부에서 돌려 준다고 설명합니다. 파이썬 쪽에도 이 그래프를 한 번에 만들어 주는 기성 함수가 있습니다. 이 날 일부러 직접 조립한 것은, 5~6일차에 그 루프 사이에 승인과 가드레일과 다른 에이전트를 끼워 넣으려면 루프의 속을 알아야 하기 때문입니다.
메시지 목록을 들고, 모델을 부르고, 도구 요청이 있으면 실행해 결과를 목록에 붙이고, 없으면 끝낸다. 이 네 가지는 파이썬의 while 문에서도, LangGraph의 그래프에서도, Java의 메서드에서도 똑같습니다. 프레임워크가 달라질 때 바뀌는 것은 "누적, 분기, 도구 실행, 반복을 누가 대신 써 주느냐"뿐입니다.
  1package com.example.react;
  2
  3import java.util.ArrayList;
  4import java.util.List;
  5
  6import org.springframework.ai.chat.client.ChatClient;
  7import org.springframework.ai.chat.messages.AssistantMessage;
  8import org.springframework.ai.chat.messages.Message;
  9import org.springframework.ai.chat.messages.ToolResponseMessage;
 10import org.springframework.ai.chat.messages.UserMessage;
 11import org.springframework.ai.chat.metadata.Usage;
 12import org.springframework.ai.chat.model.ChatResponse;
 13import org.springframework.ai.chat.prompt.ChatOptions;
 14import org.springframework.ai.chat.prompt.Prompt;
 15import org.springframework.ai.model.tool.ToolCallingChatOptions;
 16import org.springframework.ai.model.tool.ToolCallingManager;
 17import org.springframework.ai.model.tool.ToolExecutionResult;
 18import org.springframework.ai.support.ToolCallbacks;
 19import org.springframework.stereotype.Component;
 20
 21/**
 22 * react_agent.py (2/3) - "그래프" 조립.
 23 *
 24 * Spring AI에는 StateGraph가 없으므로, LangGraph 그래프의 각 부품을 메서드로 1:1 옮겼습니다.
 25 *
 26 *   START -> agent -> should_continue --(tool_calls 있음)--> tools -> agent  (사이클)
 27 *                                     --(없음)------------> END
 28 *
 29 *   AgentState.messages + add_messages  ->  List<Message> state + state.add(...)
 30 *   agent 노드                          ->  agent(state)
 31 *   should_continue                     ->  shouldContinue(ai)
 32 *   ToolNode(tools)                     ->  tools(state, response)   (ToolCallingManager 사용)
 33 *   add_edge("tools", "agent")          ->  run()의 while 루프
 34 *
 35 * 참고: 루프를 직접 보고 싶지 않다면 application.properties의 tool-calling.enabled=false를 지우고
 36 *   chatClient.prompt().system(SYSTEM_PROMPT).user(q).tools(agentTools).call().content();
 37 * 한 줄이면 Spring AI가 이 루프 전체를 내부에서 돌려 줍니다. (LangGraph의 create_react_agent 같은 것)
 38 */
 39@Component
 40public class ReactAgent {
 41
 42    static final String SYSTEM_PROMPT = """
 43            너는 삼성SDS 사내 AI 어시스턴트야.
 44
 45            [도구 사용 전략]
 46            1. 임직원 정보는 반드시 searchEmployee로 조회해. 지어내지 마.
 47            2. 계산이 필요하면 calculate를 사용해. 암산하지 마.
 48            3. 사내 문의의 담당 부서 판단은 classifyRequest를 사용해.
 49            4. 도구가 필요 없는 인사나 일반 질문에는 도구 없이 바로 답해.""";
 50
 51    /** 무한 사이클 방지. LangGraph의 recursion_limit에 해당합니다. */
 52    private static final int MAX_STEPS = 10;
 53
 54    private final ChatClient chatClient;
 55    /** llm.bind_tools(tools)에 해당: 도구 스키마를 LLM 요청에 실어 보내는 옵션 */
 56    private final ChatOptions chatOptions;
 57    /** ToolNode에 해당: tool_calls를 받아 실제 메서드를 실행하고 ToolResponseMessage로 포장 */
 58    private final ToolCallingManager toolCallingManager = ToolCallingManager.builder().build();
 59
 60    public ReactAgent(ChatClient.Builder builder, AgentTools agentTools) {
 61        this.chatClient = builder.build();
 62        this.chatOptions = ToolCallingChatOptions.builder()
 63                .toolCallbacks(ToolCallbacks.from(agentTools))
 64                .build();
 65    }
 66
 67    /** graph.stream({"messages": [HumanMessage(q)]}) 에 해당 */
 68    public String run(String question) {
 69        // AgentState.messages. SystemMessage는 여기 넣지 않고 agent()에서 매번 앞에 붙입니다.
 70        List<Message> state = new ArrayList<>();
 71        state.add(new UserMessage(question));
 72
 73        int step = 0;
 74        while (step < MAX_STEPS) {
 75            // ---- agent 노드 ----
 76            step++;
 77            System.out.printf("%n[step %d] agent 노드 -> LLM 호출 (보낸 메시지: System 1개 + 대화 %d개)%n",
 78                    step, state.size());
 79            ChatResponse response = agent(state);
 80            AssistantMessage ai = response.getResult().getOutput();
 81            state.add(ai);                                    // add_messages: append
 82            printAgentStep(response, ai);
 83
 84            // ---- should_continue (조건부 엣지) ----
 85            if (!shouldContinue(response)) {
 86                return ai.getText();                          // -> END
 87            }
 88
 89            // ---- tools 노드 ----
 90            step++;
 91            ToolResponseMessage toolMessage = tools(state, response);
 92            state.add(toolMessage);                           // add_messages: append
 93            printToolsStep(step, toolMessage);
 94            // ---- add_edge("tools", "agent"): 루프 처음으로 돌아감 (사이클) ----
 95        }
 96        throw new IllegalStateException("MAX_STEPS(" + MAX_STEPS + ")를 넘었습니다. 사이클이 끝나지 않습니다.");
 97    }
 98
 99    /** agent 노드: [SystemMessage] + state 를 도구 스키마와 함께 LLM에 보냄 */
100    private ChatResponse agent(List<Message> state) {
101        return chatClient.prompt()
102                .system(SYSTEM_PROMPT)
103                .messages(state)
104                .options(chatOptions)
105                .call()
106                .chatResponse();
107    }
108
109    /** should_continue: 마지막 AI 메시지에 tool_calls가 있으면 tools, 없으면 END */
110    private boolean shouldContinue(ChatResponse response) {
111        return response.hasToolCalls();
112    }
113
114    /**
115     * tools 노드 (ToolNode): tool_calls를 실행하고 결과를 ToolResponseMessage로 돌려줌.
116     * executeToolCalls는 "프롬프트 + AI 메시지 + 도구 결과" 전체 히스토리를 돌려주므로
117     * 이번 노드가 새로 만든 마지막 메시지(도구 결과)만 꺼내 state에 append 합니다.
118     * Spring AI는 도구 여러 개의 결과를 ToolResponseMessage 하나에 담습니다
119     * (LangChain은 ToolMessage를 도구마다 하나씩 만드는 점이 다름).
120     */
121    private ToolResponseMessage tools(List<Message> state, ChatResponse response) {
122        Prompt prompt = new Prompt(List.copyOf(state), chatOptions);
123        ToolExecutionResult result = toolCallingManager.executeToolCalls(prompt, response);
124        List<Message> history = result.conversationHistory();
125        return (ToolResponseMessage) history.get(history.size() - 1);
126    }
127
128    // ---------------- 출력용 (react_agent.py의 print 부분) ----------------
129
130    private void printAgentStep(ChatResponse response, AssistantMessage ai) {
131        System.out.println("  content: " + ai.getText());
132        if (ai.hasToolCalls()) {
133            System.out.printf("  tool_calls %d개 -> 다음은 tools 노드%n", ai.getToolCalls().size());
134            for (AssistantMessage.ToolCall tc : ai.getToolCalls()) {
135                System.out.printf("    - %s(%s)  id=%s%n", tc.name(), tc.arguments(), tc.id());
136            }
137        } else {
138            System.out.println("  tool_calls 없음 -> END (이게 최종 답변)");
139        }
140        Usage usage = response.getMetadata().getUsage();
141        if (usage != null) {
142            System.out.printf("  토큰: 입력 %d / 출력 %d%n", usage.getPromptTokens(), usage.getCompletionTokens());
143        }
144    }
145
146    private void printToolsStep(int step, ToolResponseMessage toolMessage) {
147        System.out.printf("%n[step %d] tools 노드 -> 도구 %d개 실행, 결과를 ToolResponseMessage로 반환%n",
148                step, toolMessage.getResponses().size());
149        for (ToolResponseMessage.ToolResponse r : toolMessage.getResponses()) {
150            System.out.printf("    - %s -> %s  (id=%s)%n", r.name(), r.responseData(), r.id());
151        }
152        System.out.println("  -> 다음은 다시 agent 노드 (사이클)");
153    }
154}
 1package com.example.react;
 2
 3import java.util.Map;
 4
 5import org.springframework.ai.chat.client.ChatClient;
 6import org.springframework.ai.tool.annotation.Tool;
 7import org.springframework.ai.tool.annotation.ToolParam;
 8import org.springframework.stereotype.Component;
 9
10/**
11 * react_agent.py (1/3) - 도구 준비.
12 *
13 * Python의 @tool 함수 3개 -> @Tool 메서드 3개.
14 * description이 LLM에게 전달되는 도구 설명(= Python docstring)입니다.
15 */
16@Component
17public class AgentTools {
18
19    // 교육용 더미 데이터입니다. 실제 사내 데이터와 무관합니다.
20    private static final Map<String, String[]> EMPLOYEES = Map.of(
21            "김하늘", new String[]{"클라우드운영팀", "haneul.kim@samsungsds.example.com"},
22            "박도윤", new String[]{"물류플랫폼팀", "doyun.park@samsungsds.example.com"}
23    );
24
25    /** classify_request 안에서 쓰는 '도구 없는' LLM. Python의 plain llm에 해당합니다. */
26    private final ChatClient plainLlm;
27
28    public AgentTools(ChatClient.Builder builder) {
29        this.plainLlm = builder.build();
30    }
31
32    @Tool(description = "임직원 이름으로 소속 팀과 이메일을 조회합니다. 임직원 정보 질문에 사용하세요.")
33    public String searchEmployee(@ToolParam(description = "임직원 이름. 예: 김하늘") String name) {
34        String[] e = EMPLOYEES.get(name);
35        if (e != null) {
36            return name + " / " + e[0] + " / " + e[1];
37        }
38        return "'" + name + "' 님을 찾을 수 없습니다. 조회 가능한 임직원: " + EMPLOYEES.keySet();
39    }
40
41    @Tool(description = "수식 문자열을 계산해 정확한 결과를 반환합니다. 예: '3480000 * 1.1', '48 * 1.12'")
42    public String calculate(@ToolParam(description = "사칙연산 수식") String expression) {
43        // Python은 eval()을 썼지만 Java에는 eval이 없으므로 작은 파서로 대신합니다.
44        // BigDecimal이라 3480000 * 1.1 = 3828000.0 처럼 부동소수 오차가 없습니다.
45        try {
46            return ExpressionCalculator.evaluate(expression).toPlainString();
47        } catch (RuntimeException e) {
48            return "계산 실패: " + e.getMessage() + ". 수식 형식을 확인하세요.";
49        }
50    }
51
52    @Tool(description = "사내 문의 문장을 받아 담당 부서를 IT지원, 인사, 총무 중 하나로 분류합니다. 문의 접수와 부서 배정 질문에 사용하세요.")
53    public String classifyRequest(@ToolParam(description = "사내 문의 원문") String text) {
54        // 도구 안에서 다시 LLM을 호출합니다. 도구 안의 AI입니다.
55        String result = plainLlm.prompt()
56                .user("다음 사내 문의의 담당 부서를 IT지원, 인사, 총무 중 하나로만 답하세요. "
57                        + "다른 말은 붙이지 마세요.\n\n문의: " + text)
58                .call()
59                .content();
60        return result == null ? "" : result.strip();
61    }
62}
 1package com.example.react;
 2
 3import java.math.BigDecimal;
 4import java.math.MathContext;
 5
 6/**
 7 * calculate 도구용 아주 작은 사칙연산 파서 (+ - * / 괄호, 단항 -).
 8 * Python 버전의 eval(expression, {"__builtins__": {}}, {}) 자리를 대신합니다.
 9 *
10 * 문법:
11 *   expr   := term (('+' | '-') term)*
12 *   term   := factor (('*' | '/') factor)*
13 *   factor := '-' factor | '(' expr ')' | number
14 */
15final class ExpressionCalculator {
16
17    private final String s;
18    private int pos;
19
20    private ExpressionCalculator(String s) {
21        this.s = s;
22    }
23
24    static BigDecimal evaluate(String expression) {
25        ExpressionCalculator p = new ExpressionCalculator(expression.replace(" ", ""));
26        BigDecimal value = p.expr();
27        if (p.pos != p.s.length()) {
28            throw new IllegalArgumentException("알 수 없는 문자 '" + p.s.charAt(p.pos) + "'");
29        }
30        return value.stripTrailingZeros();
31    }
32
33    private BigDecimal expr() {
34        BigDecimal v = term();
35        while (pos < s.length()) {
36            char c = s.charAt(pos);
37            if (c == '+') { pos++; v = v.add(term()); }
38            else if (c == '-') { pos++; v = v.subtract(term()); }
39            else break;
40        }
41        return v;
42    }
43
44    private BigDecimal term() {
45        BigDecimal v = factor();
46        while (pos < s.length()) {
47            char c = s.charAt(pos);
48            if (c == '*') { pos++; v = v.multiply(factor()); }
49            else if (c == '/') { pos++; v = v.divide(factor(), MathContext.DECIMAL64); }
50            else break;
51        }
52        return v;
53    }
54
55    private BigDecimal factor() {
56        if (pos >= s.length()) throw new IllegalArgumentException("수식이 끝났습니다");
57        char c = s.charAt(pos);
58        if (c == '-') { pos++; return factor().negate(); }
59        if (c == '(') {
60            pos++;
61            BigDecimal v = expr();
62            if (pos >= s.length() || s.charAt(pos) != ')') throw new IllegalArgumentException("')'가 없습니다");
63            pos++;
64            return v;
65        }
66        int start = pos;
67        while (pos < s.length() && (Character.isDigit(s.charAt(pos)) || s.charAt(pos) == '.')) pos++;
68        if (start == pos) throw new IllegalArgumentException("숫자가 필요한 위치: " + start);
69        return new BigDecimal(s.substring(start, pos));
70    }
71}
 1package com.example.react;
 2
 3import java.util.List;
 4
 5import org.springframework.boot.CommandLineRunner;
 6import org.springframework.boot.SpringApplication;
 7import org.springframework.boot.autoconfigure.SpringBootApplication;
 8import org.springframework.context.annotation.Bean;
 9
10/**
11 * react_agent.py (3/3) - 실행부.
12 * Python의 if __name__ == "__main__": 블록에 해당합니다.
13 */
14@SpringBootApplication
15public class ReactAgentApplication {
16
17    public static void main(String[] args) {
18        SpringApplication.run(ReactAgentApplication.class, args);
19    }
20
21    @Bean
22    CommandLineRunner run(ReactAgent agent) {
23        return args -> {
24            List<String> questions = List.of(
25                    "김하늘 님 소속 팀 알려주고, 연봉 3480000에 10% 인상하면 얼마인지 계산해줘.",
26                    "노트북 화면이 안 켜져요. 어느 부서에 문의해야 하나요?"
27            );
28
29            for (String q : questions) {
30                System.out.println("\n" + "=".repeat(70));
31                System.out.println("질문: " + q);
32                String answer = agent.run(q);
33                System.out.println("\n최종 답변:\n" + answer);
34            }
35        };
36    }
37}
 1spring.application.name=spring-ai-react
 2spring.main.web-application-type=none
 3
 4# Python: ChatBedrockConverse(model=..., region_name="us-east-1")
 5spring.ai.bedrock.aws.region=us-east-1
 6spring.ai.bedrock.converse.chat.model=us.anthropic.claude-sonnet-4-5-20250929-v1:0
 7
 8# 자격 증명: 아래를 비워 두면 AWS 기본 자격 증명 체인(환경 변수, ~/.aws/credentials 등)을 씁니다.
 9# Python 쪽 .env 값을 환경 변수로 넣어 두면 그대로 동작합니다.
10#spring.ai.bedrock.aws.access-key=${AWS_ACCESS_KEY_ID}
11#spring.ai.bedrock.aws.secret-key=${AWS_SECRET_ACCESS_KEY}
12
13# ChatClient가 도구 호출 루프를 알아서 돌리지 않게 끕니다.
14# 루프(agent -> should_continue -> tools -> agent)는 ReactAgent에서 직접 돌립니다. (LangGraph 그래프와 같은 구조)
15spring.ai.chat.client.tool-calling.enabled=false
spring-ai-starter-model-bedrock-converse 둘뿐입니다. 웹 서버 없이 콘솔로만 실행하는 구성입니다.1<?xml version="1.0" encoding="UTF-8"?> 2<project xmlns="http://maven.apache.org/POM/4.0.0" 3 xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" 4 xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd"> 5 <modelVersion>4.0.0</modelVersion> 6 7 <!-- Spring AI 2.0.x는 Spring Boot 4.0.x / 4.1.x 지원 --> 8 <parent> 9 <groupId>org.springframework.boot</groupId> 10 <artifactId>spring-boot-starter-parent</artifactId> 11 <version>4.0.0</version> 12 <relativePath/> 13 </parent> 14 15 <groupId>com.example</groupId> 16 <artifactId>spring-ai-react</artifactId> 17 <version>0.0.1-SNAPSHOT</version> 18 <name>spring-ai-react</name> 19 <description>react_agent.py를 Spring AI로 옮긴 실습</description> 20 21 <properties> 22 <java.version>21</java.version> 23 <spring-ai.version>2.0.2</spring-ai.version> 24 </properties> 25 26 <dependencyManagement> 27 <dependencies> 28 <dependency> 29 <groupId>org.springframework.ai</groupId> 30 <artifactId>spring-ai-bom</artifactId> 31 <version>${spring-ai.version}</version> 32 <type>pom</type> 33 <scope>import</scope> 34 </dependency> 35 </dependencies> 36 </dependencyManagement> 37 38 <dependencies> 39 <!-- 웹 서버 없이 콘솔 실행만 하므로 기본 starter만 --> 40 <dependency> 41 <groupId>org.springframework.boot</groupId> 42 <artifactId>spring-boot-starter</artifactId> 43 </dependency> 44 45 <!-- Python의 langchain_aws.ChatBedrockConverse에 해당 --> 46 <dependency> 47 <groupId>org.springframework.ai</groupId> 48 <artifactId>spring-ai-starter-model-bedrock-converse</artifactId> 49 </dependency> 50 </dependencies> 51 52 <build> 53 <plugins> 54 <plugin> 55 <groupId>org.springframework.boot</groupId> 56 <artifactId>spring-boot-maven-plugin</artifactId> 57 </plugin> 58 </plugins> 59 </build> 60</project>
파일이 아홉 개, 설명 자료가 여덟 개나 되면 무엇이 무엇과 이어지는지 놓치기 쉽습니다. 강의 끝에 이 폴더 전체를 분석 도구(graphify)에 넣어 지식 그래프로 만든 자료가 있습니다. 여기서 말하는 그래프는 LangGraph의 실행 그래프가 아니라, 코드의 함수와 개념을 점으로, 그 관계를 선으로 그린 지도입니다.
day3_practice 폴더의 함수, 클래스, 설명 자료 속 개념을 점 168개와 선 298개로 연결하고 11개 묶음으로 색을 나눈 탐색형 그래프입니다. 점을 누르면 그 항목의 정보가 보이고, 묶음별로 켜고 끌 수 있습니다.
분석 보고서(graphify-out/GRAPH_REPORT.md)가 찾아낸 묶음은 이 날의 강의 순서와 거의 겹칩니다. 연결이 가장 많은 항목으로는 retrieve(), agent 노드, tools 노드, classify_request(), 그리고 "ReAct 루프(Reason → Act → Observe)"가 꼽혔습니다. 여러 실습이 결국 ReAct 에이전트 한 곳으로 모인다는 점이 연결 수로도 드러납니다.
| 보고서의 묶음 | 해당 파일 | 이 페이지의 절 |
|---|---|---|
| 체인 한계와 수동 ReAct | chain_limit.py, manual_react.py | 체인의 한계, 수동 ReAct |
| 일렬 그래프 hello_graph | hello_graph.py | 첫 그래프 |
| 공통 import와 메시지 State / 품질 사이클과 리듀서 | reducer.py, cycle.py | reducer, 사이클 |
| 조건부 엣지와 의도 분류 | conditional.py | 조건부 엣지 |
| 분기·루프 재검색 그래프 | branch_loop_graph.py | 분기와 루프 |
| ReAct 루프 개념과 안전장치 / ReAct 파이프라인 다이어그램 / 에이전트 도구와 그래프 그림 | react_agent.py 와 그 설명 자료들 | 그래프 ReAct, 실행 추적 |
| LangGraph 서버 설정 | langgraph.json | 개발 서버 |
이 그래프의 데이터(graphify-out/graph.json)에는 spring_ai_react/ 의 Java 소스가 들어 있지 않습니다. 파이썬 파일과 설명 자료, 그림만 다룬 지도입니다. 또 보고서가 "길이 기반 품질 점수 (min(len/200, 1.0))"라고 적은 항목은 앞에서 본 이전 버전의 식입니다. 지도는 만든 시점의 스냅숏이므로, 세부 수치는 지금 코드에서 확인합니다.
에이전트는 "모델 노드 + 도구 노드 + tool_calls 가 있으면 도구로 가는 조건부 엣지 + 도구에서 모델로 돌아가는 사이클"이고, 그 사이를 흐르는 것은 reducer가 누적해 주는 메시지 목록 하나입니다.
| 오늘 만든 것 | 남은 숙제 | 이어지는 날 |
|---|---|---|
ToolNode 에 맡긴 도구 실행 | 도구 설명은 어떻게 써야 모델이 잘 고르나. 도구가 실패하면. 남이 만든 도구를 가져다 쓰려면 | 4일차 도구 설계와 MCP |
| 실행이 끝나면 사라지는 State | 대화를 이어 가고, 프로그램을 껐다 켜도 남게 하려면 | 5일차 체크포인터와 메모리 |
| 모델이 부르면 곧바로 실행되는 도구 | 위험한 도구는 실행 전에 사람이 승인하고, 입력과 출력을 걸러 내려면 | 5일차 사람 승인과 가드레일 |
| 에이전트 하나, 도구 셋 | 일이 커져 에이전트 하나로 감당이 안 되면 | 6일차 멀티 에이전트 |
| 매 턴 즉석에서 판단하는 루프, 노드 단위 추적 | 먼저 계획을 세우고 실행하려면. 숨은 호출까지 추적하고 품질을 채점하려면 | 7일차 Plan-and-Execute, 추적, 평가 |
{"word_count": 2} 만 돌려줬는데 State의 다른 칸이 사라지지 않는 이유는 무엇인가요?노드의 반환값은 새 State가 아니라 "바꿀 칸"의 목록이기 때문입니다. LangGraph가 그 dict를 기존 State에 합칩니다. reducer가 없는 칸은 새 값으로 덮어쓰고, 돌려주지 않은 칸은 그대로 둡니다.
messages: list 와 messages: Annotated[list, add_messages] 는 실행 결과가 어떻게 다른가요?앞의 것은 노드가 메시지를 돌려줄 때마다 리스트가 통째로 교체되어 이전 대화가 사라집니다. 뒤의 것은 add_messages reducer가 새 메시지를 기존 리스트 뒤에 붙입니다. reducer.py 에서 메시지가 2개, 4개로 쌓인 것이 그 결과입니다. 다만 누적은 한 번의 실행 안에서만 일어나고, 실행 사이의 기억은 체크포인터가 맡습니다.
라우팅 함수는 노드가 아니어서 반환값이 "다음 노드의 이름"으로만 쓰입니다. State를 갱신하는 통로가 없습니다. 판단 결과를 남기고 싶으면 classify 나 check_quality 처럼 노드에서 State에 적고, 라우팅 함수는 그 값을 읽기만 하게 만듭니다.
cycle.py 는 어떻게 반복하나요? 그리고 무엇이 반복을 멈추나요?조건부 엣지의 라우팅 함수 route_quality 가 이미 지나온 노드 이름 "generate" 를 돌려주면 그리로 되돌아가고, 그것이 반복입니다. 멈추는 길은 라우팅 함수가 END 를 돌려주는 것뿐이며, 품질 통과와 시도 한도(attempts >= 10) 두 조건이 있습니다. 그 바깥에 LangGraph의 recursion_limit 이 마지막 방어선으로 있지만, 기본값은 버전마다 다르므로 직접 정해 주는 편이 안전합니다.
react_agent.py 에서 수동 루프의 if not ai_message.tool_calls: break 와 while 은 각각 무엇이 됐나요?if ... break 는 라우팅 함수 should_continue 와 add_conditional_edges("agent", should_continue, {"tools": "tools", "end": END}) 가 됐고, while 은 add_edge("tools", "agent") 한 줄이 됐습니다. 도구를 찾아 실행하고 ToolMessage로 포장하던 for 문은 ToolNode(tools) 가 대신합니다.
아닙니다. classify_request 처럼 도구 안에서 모델을 부르는 도구가 실행됐다면 그만큼 더 호출됩니다. 노드 단위 추적에는 이 내부 호출이 따로 보이지 않으므로, 비용을 따질 때는 도구 안의 호출을 별도로 세어야 합니다.
이 페이지에 실린 코드 파일 전체 목록입니다. 파일 이름을 누르면 본문에서 그 코드가 있는 자리로 이동합니다.
| 파일 | 무엇을 하는 코드인가 | 분량 |
|---|---|---|
chain_limit.py | 체인만으로는 재검색을 표현할 수 없어 바깥에 while 문을 두게 되는 과정 확인 (LLM 미사용) | 77줄 |
state_schema.py | TypedDict로 State 스키마를 선언하고, 실행 시점에는 dict임을 확인 (LLM 미사용) | 13줄 |
hello_graph.py | 노드 3개를 일렬로 이어 State가 단계마다 어떻게 바뀌는지 관찰 (LLM 미사용) | 69줄 |
reducer.py | add_messages reducer가 메시지를 덮어쓰지 않고 누적하는 것을 확인 (LLM 미사용) | 35줄 |
conditional.py | 모델이 분류한 intent 값에 따라 답변 노드와 고정 반응 노드로 분기 | 92줄 |
cycle.py | 답변 생성 → 길이로 품질 평가 → 미달이면 재생성하는 사이클 그래프 | 92줄 |
branch_loop_graph.py | 검색 실패 시 질문을 바꿔 재검색하는 분기 + 루프 그래프 (LLM 미사용) | 111줄 |
manual_react.py | LangGraph 없이 while 문으로 ReAct 루프(도구 선택 → 실행 → 관찰 → 재판단)를 직접 구현 | 77줄 |
react_agent.py | 수동 ReAct 루프를 StateGraph로 옮긴 에이전트: agent 노드 + ToolNode + 조건부 엣지 + 사이클 | 153줄 |
langgraph.json | langgraph dev 가 읽는 설정: react_agent 와 cycle 두 그래프를 등록 | 8줄 |
ReactAgent.java | 그래프의 agent 노드, should_continue, tools 노드, 사이클을 메서드와 while 루프로 옮긴 본체 | 154줄 |
AgentTools.java | 파이썬의 @tool 함수 3개를 @Tool 메서드 3개로 옮긴 도구 모음 | 62줄 |
ExpressionCalculator.java | eval 대신 쓰는 사칙연산 파서 (+ - * / 괄호, 단항 -, BigDecimal) | 71줄 |
ReactAgentApplication.java | 실행부: 파이썬과 같은 질문 두 개를 에이전트에 넣고 최종 답변 출력 | 37줄 |
application.properties | Bedrock 리전과 모델, 자격 증명 방식, 자동 도구 호출 루프 끄기 설정 | 15줄 |
pom.xml | Maven 빌드 설정: Spring Boot 4.0.0, Spring AI 2.0.2, Java 21, Bedrock Converse 스타터 | 60줄 |
TypedDict 로 칸의 이름과 타입을 선언하며, 실행 시점에는 평범한 dict입니다.add_node("이름", 함수) 로 등록합니다.add_edge 로 그은 것은 목적지가 고정입니다.compile() 해야 실행할 수 있습니다.__start__, __end__ 로 그려집니다.invoke, stream 으로 실행할 수 있는 그래프 객체로 바꾸는 단계.graph.stream 이 단계마다 무엇을 내줄지 정하는 옵션. "values" 는 그 시점의 State 전체, "updates" 는 {노드 이름: 그 노드가 돌려준 값}입니다.Annotated[타입, reducer] 로 칸마다 지정하며, 지정하지 않으면 덮어쓰기입니다.id 의 메시지는 교체합니다.add_conditional_edges(출발 노드, 라우팅 함수, 목적지 정보) 로 등록합니다.GraphRecursionError 가 납니다. config={"recursion_limit": N} 으로 정합니다.tool_calls 만 돌려줍니다.Literal 과 함께 써서 분기에 쓸 값의 범위를 묶습니다.langgraph dev)가 읽는 설정 파일. 어느 파일의 어느 변수를 그래프로 등록할지, 환경 변수 파일이 어디인지를 적습니다.